これまでの4本で、なぜ学習が必要なのか、フィットの語彙がなぜ定着しないのか、ブランドを学習させると何がついてくるのか、セラーが何を直しているのかを書いてきました。そのたびに「もう一度回してみました」と一行で済ませて先に進んでいました。今回はその一行の内側の話です。
00 · What Goes In
学習1件に何が入るのか
まずは用語をそろえるところから始めます。
モデルを学習させるというのは、「これを入れたら、これが出てくるべきだ」を何百回も見せることです。服の写真を入れたら、その服を着た写真が出てくるべきだ。これを見せ続けると、モデルはそのルールを身につけます。
その1件に入るものは3つです。
最初の2つは当然ですが、3つ目がなぜ必要なのかはピンとこないかもしれません。画像を2枚渡すだけだと、モデルは2枚の間から何を学べばいいのかがわかりません。服の形なのか、背景なのか、ポーズなのか、判断がつかないのです。
そこで、文章でも一緒に書いて渡します。
·
1件に付ける文章
wide-leg pants, cropped, beige twill, front pleats, belt loops,
worn by the person, full body, plain background
この文章が、あとでそのモデルに話しかけるときの言葉になります。学習のときにワイドなパンツを wide-leg と呼んで教えたなら、あとでもそう呼ばないと通じません。2本目は、この言葉を何に決めるかという話でした。
さらに、文章の先頭にほかでは一切使わない単語を1つ埋め込んでおくことができます。ブランド名のようなものです。
·
先頭に単語を1つ埋め込んだ文章
<ブランド名> wide-leg pants, cropped, beige twill, front pleats,
worn by the person, full body, plain background
こうして学習させておくと、その単語を入れたときだけ、学んだものが出てきます。入れなければ元のモデルのまま動きます。スイッチが1つできるようなものです。
だから、学習を始める前に決めておくべきことがあります。
ブランドを学習させるときは、当然後者です。1つのブランドを学んだせいでほかのブランドの服までその雰囲気で出てくるようでは使えません。
この単語をいくつに分けるかも同時に決めます。1つにまとめると楽ですが、性質が正反対のものを1つの単語に詰め込むと、その中間が出てきます。幅の広い服と体にフィットする服を同じ単語で教えると、どちらでもない中途半端なものが出てきます。前回見た「レギュラーフィット」と同じ構図です。
そしてこの文章は、人がゼロから全部書くわけではありません。服の写真をAIに渡して「この服を説明して」と頼み、下書きを受け取ってから、それを直して使います。何百枚に1つずつ手で書くのは無理です。
ここまでが素材です。画像のペアと文章、この3点セットが数百個集まれば、学習を1回回せます。ここから先は、それを作って回すツールをどう設計したかという話です。
01 · Two Hands
人とエージェントが一緒に回します
学習1回には多くの手間がかかります。画像を集め、どの写真同士が1セットなのかをまとめ、文章を付け、条件を決め、回し、出てきたものを見ます。
このうち人が必ずやらなければならないのは2つだけだと考えました。
運用ドキュメントにはこう書いてあります。「承認前にGPUを起動するな。判定を代わりにするな。それ以外はお前がやる。」
人が抜けて機械が全部やる構造ではありません。1つの学習を2者で分担して進めます。エージェントが素材を作って「こう回しましょう」と持ってきて、人が回すかどうかを決め、エージェントが回して見守り、出てきたものを人が見ます。
人の役割をこの2つに絞ったら、画面に何が必要かが決まりました。画像をアップロードしてまとめて文章を付ける画面は不要になり、代わりにお金が出ていく前に何を回すのかを確認する画面と、出てきたものを並べて見る画面が必要になりました。
02 · No Screen For That
データを作る画面はそもそも作りませんでした
普通、こういうツールを作るときは、アップロード画面、画像をまとめる画面、文章を直す画面から作ります。私たちはそれを作りませんでした。
画像を入れ、まとめ、文章を付け、セットを作る作業は、すべてエージェントがAPIで行います。画面には作る場所がありません。
作り込みが足りないのではなく、あえて作らなかったのです。人がクリックでやる仕事ではないと考えたからです。何百枚に文章を1つずつ付ける作業を画面でやると、画面をよく作れば作るほど、人がその仕事をやり続けることになります。
そこで画面は、人が見るべきものだけに絞りました。今何が回っているのか、何が出てきたのか、そしてお金がかかるGPUの起動と停止です。
その代わり、画面にはこんなものが付いています。
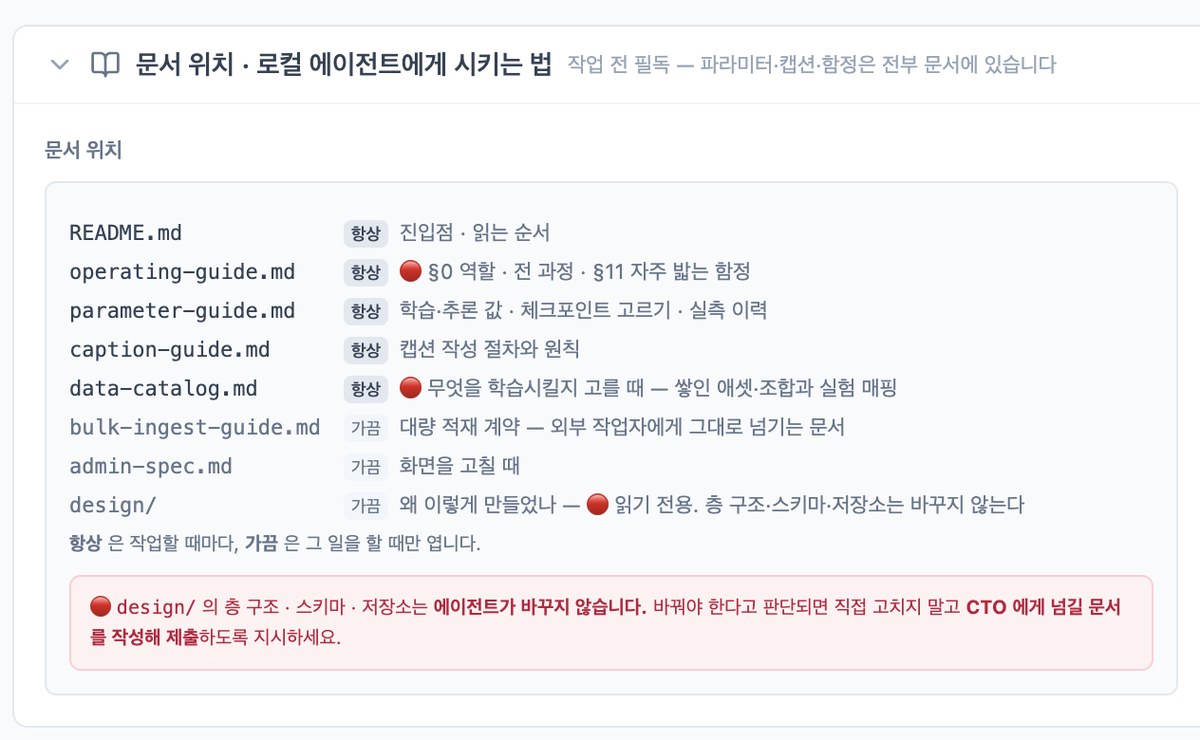 エージェントに何を読ませ、何をさせるかが画面に書いてあります。パネル(韓国語表記)の見出しは「ドキュメントの場所 · ローカルエージェントへの指示の出し方」です。「常に」のドキュメント(入口と読む順番、役割とよくある落とし穴、学習・推論の値とチェックポイントの選び方、キャプションのルール、データカタログ)は毎回読み、「ときどき」のドキュメント(大量投入の取り決め、管理画面の仕様、design フォルダ)はその作業をするときだけ開きます。赤い枠には触ってはいけないものが書かれています。
design/ の層構造・スキーマ・ストレージはエージェントが変更せず、変える必要があると判断したら自分で直さずにCTOへ渡す文書を書いて提出する、という内容です。人がデータを作る画面の代わりに、これがある格好です。
働くのがエージェントなので、画面の役割も変わります。ボタンを並べることではなく、何を読み、何に触れてはいけないかを伝えることになります。
03 · Structure Only
まだわからないことにはルールを作りません
ツールを作るとき、いちばん長く悩んだのがこれです。何をツールが強制し、何を毎回新しく決められるようにしておくか。
強制すればミスは減りますが、その外側の実験がふさがれます。開けておけば何でも試せますが、あとで互いに比較できなくなります。そこで強制するものを3つに絞りました。
構造。前の節で見たあの3点セットですが、1つ違いがあります。前の節では、入力も出てくるべきものも画像でした。でも、ツールはそれが画像でなければならないとは決めていません。この3点の形さえ守ればいいのです。
なので入力は服の写真1枚でもいいし、人の写真と服の写真の2枚でもいいし、そもそも画像ではなくテキストでもかまいません。のちにテキスト学習がそのままこの中に入ってこられたのは、そのためです。
再現。前の節で、文章はAIに下書きを出してもらって使うと書きました。すると、こういうことが起きます。半年後にその文章を見返したとき、なぜこういう文章になったのかがわからないのです。どう指示して出てきた下書きなのかが残っていないからです。
そこで、完成した文章だけを保存するのはやめました。その下書きを出すときにAIに何と指示したのかを、文章の隣に一緒に保存します。そうすれば、あとで「この実験は、こう指示して出てきた文章で回したのか」とたどり直せます。
これが必要な理由はもう1つあります。同じ画像をAIにもう一度入れても、同じ下書きは出てきません。だから「保存しなくても、また出せばいい」はここでは通用しません。
経路。学習をかけ、GPUを立ち上げ、出てきた結果を受け取る作業は、すべて決められた1つの通り道からだけ呼ぶようにしました。急いでいるときに近道を1本通しておくと、その場は速いです。でも、問題が起きたときにどこを見ればいいのかが、近道を通した人の頭の中にしか残りません。
この3つ以外について、ツールは口を出しません。
設計の途中で、このうち1つ目をツールが手伝おうという話が出ました。使える語彙をリストで管理し、文章のテンプレートを用意するというものです。魅力的でした。文章がばらばらだとあとで比較しにくいですが、テンプレートがあれば足並みがそろいます。
見送りました。そのテンプレートは結局「私たちが今よいと思っている文章」であって、作った瞬間にその外側は実験の対象から外れてしまいます。でも前回見たとおり、どんな文章がよい文章なのかは、まだわかっていません。
理由はこう書き残してあります。「何を統制すべきかわからない段階で統制の仕組みを作ると、その仕組みが実験を縛る。」
これまでの4本は、すべてそうやって出てきた結果です。どんな言葉が効くのかを先に決めず、回して数えてみてから初めてわかりました。その前に文章テンプレートを作っていたら、その外側は測ってみようとすら思わなかったはずです。
決めすぎなかったおかげは、あとになって効いてきました。今このツールで回っている学習は2種類です。1つは画像学習で、ブランドのルックブックを入れて、そのブランドらしく着せるようにするもの(3本目)。もう1つはテキスト学習で、セラーが直した文章を入れて、商品説明をそのように書かせるもの(4本目)です。
学ぶものも違えば、出てくるものも違います。それでも素材をまとめ、文章を付け、セットを作り、条件をかけて回し、出てきたものを比べる流れは同じです。層を学習の種類に縛っていなかったので、テキスト学習を始めるときに新しく作ったものはほとんどありませんでした。
04 · Why Three Layers
アセット · 組み合わせ · レコードに分けた理由
最初はひとかたまりでした。何を入れて何が出てくるべきか、そしてそこに付ける文章が、1つのドキュメントの中に一緒に入っていました。それを3つに分けました。
分けた理由は、2つの境目でそれぞれ違います。
アセットと組み合わせを分けた理由:写真1枚が複数のまとまりに入るからです。同じ平置きカットが「服1枚を入れて着用ショットを出す」にも入り、「人の写真と服の写真の2枚を入れて着用ショットを出す」にも入ります。画像にまとまりを刻んでしまうと、その画像は1通りにしか使えません。
だから画像はどこにも縛らないままにしておきます。実験を1つ作るたびに画像を登録し直す構造だったころは、同じ写真が何セットもでき、片方で消すともう片方が存在しないファイルを指すことまで起きました。
組み合わせとレコードを分けた理由:2つの寿命が違うからです。写真をまとめる作業は時間がかかり、一度やっておけばずっと使います。文章は実験ごとに変わります。一緒に束ねていると、文章を1つ変えるためにまとまりを丸ごと作り直すことになり、まとまりを使い回そうとすると昔の文章がついてきます。
この設計の理由は、ドキュメントにこう残っています。「アセットを組み合わせてデータセットを準備するのが大変なのだから、これが再利用できるのがいい。」
分けてみたら、詰まっていた実験がほどけました。同じ写真のまとまりに文章を2通り付けておき、どちらがよく学ぶかを比べるという実験です。以前は1つのまとまりに文章が1つしかなかったので、2つ目を作る場所がなく、上書きして回し直していました。そうすると前のものが消えて、比べる相手がいなくなります。
組み合わせに名前を付けることも、このとき決めました。入力する画像が複数枚になると、一覧を見ただけではどれが何なのかわからないからです。
そして、その上にセットがあります。
レコードは学習に入ることができる1件です。入ることができるというだけで、今回入るという意味ではありません。積み上げたレコードの中から今回の実験はこれで回すと選んで入れたものがセットです。
これがなぜ別に必要かというと、同じレコードが複数のセットに入るからです。服120着で学習セットを作り、そこに入らなかった36着で検証セットを作ります。次の実験では同じ素材を別の分け方で入れます。レコードに「今回のセット」を刻むと、その次の実験ができなくなります。
まとめるとこうです。アセットは素材、組み合わせは素材をまとめたもの、レコードはそこに言葉を付けたもの、セットはその中から今回使うものを選んだもの。前の3つは積み上がっていき、セットは実験ごとに新しく作ります。
セットに条件をかけて実際に回したものがランで、出てきたものをほかの服で試すのが検証です。
05 · Tags, Not Folders
画像を種類ごとに分けて入れません
画像を入れるとき、「これはフィッティングショット学習用」のような場所には入れません。そのまま入れてタグを付けます。平置きカットなのか、着用カットなのか、どの商品なのか、どこから来たものなのか。
種類ごとに分けて入れたほうが探しやすいのですが、そうはしませんでした。私たちが学習させるものが1種類ではないからです。
ここで問題が出てきます。同じ写真1枚が、実験によって別のものになるのです。着こなしを学ばせる実験ではその写真は出てくるべき画像ですが、背景を学ばせる実験では同じ写真が背景の素材になります。
種類を決めて分けて入れるには、この先どんな学習をするのかを前もって知っていなければなりません。それがわからないまま分けて入れると、あとで新しい種類ができるたびに素材を入れ直すことになります。
そこで画像は1か所に入れず、条件で絞り込みます。素材を選ぶときは「このフォルダを開く」のではなく、「着用カットで、かつこの商品カテゴリーのもの」のように、そのとき必要な条件で取り出します。
おかげで新しい種類の学習を始めるときも、画像を入れ直しません。すでにあるものにタグを足せばいいのです。タグは複数付けられますし、あとからいくらでも追加できます。
06 · No Purpose Field
素材に用途を刻みません
同じ考え方は1つ上の層にも当てはまります。学習に使うまとまりと検証に使うまとまりを別々に作りません。セットには用途を書く欄そのものがありません。学習に使うか検証に使うかは、回すときに決めます。
設計のときにこう整理しました。「私たちのレコードは学習にも検証にも使われうる。そのセットをどう組むかによって変わるものだ。」
しばらくの間、この原則に反していたものが1つありました。画像ごとに「これは評価専用」と刻んでおく機能です。便利そうに見えましたが、素材に用途を刻むと、その画像は永遠に学習に使えなくなります。取り払いました。
取り払うときに、1つ一緒に決めたことがあります。値だけ抜いて項目を残してはいけない、ということです。「評価専用」だけを抜くと「学習用」が1つ残り、用途の項目が半分生きている状態になって、次の人がまたそこを埋めてしまいます。なので項目ごとなくしました。
この原則のおかげでできる実験があります。学習に入れたまとまりを、そのまま検証に入れてみることです。モデルが学んだものをどれだけそのまま出すかがわかり、それがこの学習で出せる最高点です。そこまで届かなければ学び足りず、そこだけうまくて新しい服で崩れるなら丸暗記です。
07 · Freeze
「また回せばいい」が成り立ちません
先ほど、文章は出し直すと変わると書きました。同じ問題がまとまりにもあります。セットに入ったレコードは、時間が経つにつれて文章が直され、画像が消されることもあります。すると先月回したあの学習が、正確に何で回ったのかがぼやけてきます。
そこで学習をかけるとき、その時点のセットを丸ごとコピーして別に残します。実際にGPUに入るのはセットではなく、このコピーです。
同じ理由で、一度回したまとまりは修正できないようにしてあります。直したければ新しく作ります。数か月後に「あのとき何を入れたっけ」ともう一度問われる場面は必ず来ますが、そのとき根拠になるのはまとまりではなく、そのときに取っておいた写しです。
だからどの学習でも、何で回して何で検証したのかを、いつでもそのまま取り出せます。半年前の学習でも、そのとき入れたものをそのままもう一度入れられます。
08 · The Queue
仕事をかけておけば、GPUが拾っていきます
学習と検証はGPUを使います。起動しておくと何もしていなくてもお金がかかり続け、自動では止まりません。そこでGPUを起動してから仕事をさせるのではなく、仕事をかけておいてからGPUを起動します。
01仕事をかける回すセットと条件を待ち行列に載せます
02人が承認する何枚で、どれくらいかかり、いくらかかるのかを見て決めます
03GPUを起動する起動すると、待ち行列から自分の仕事を拾っていきます
04終わったら止める待たずにすぐ削除します
順番が逆ではいけません。空の待ち行列に対して先にGPUを起動すると、やることもなく回るだけで、その間も料金はそのままかかります。だから、かけてから起動するという順番をドキュメントに明記してあります。
仕事ごとにどのGPUが持っていくかを指定することもできます。複数の実験を同時に回すとき、ほかの人が起動したGPUが自分の仕事を持っていってしまうと順番がこじれるからです。指定しなければそもそも投入できないようにしてあります。
こうして待ち行列を埋めておき、必要なときだけGPUを起動します。1つの学習が回っている間に次に回すものを先にかけておけますし、その合間GPUは止まっています。
09 · The Last One Is Never Best
最後まで回したものがいちばんよかったことはありません
学習は一度で終わるものではなく、同じ資料を何度も繰り返して見ます。そして途中で、それまでに学んだ状態を保存し続けます。学習が1つ終わると、その途中の保存版が20個ほど残ります。最後まで行ったものがいちばんよさそうに思えますが、これまで回した学習で、最後が最適だったことは一度もありません。
97%途中の地点:生地の質感がオリジナルにこれだけ近い
82%最後まで回したもの:かえって下がった
もっと回せばもっと似てきそうなものですが、逆に向かいます。前回書いたとおりです。学習しすぎると、付随する要素から崩れていきます。靴が1つの形に収束し、背景がグレーに寄っていきます。学ばせたかったフィットはその時点までは無事なのに、周りが先に固まってしまうのです。
だから、終わったもの1つだけを使うことはしません。途中の保存版をいくつか選んで同じ服で全部回してみて、並べて見ます。どこで取り出すかが、条件を変えるのと同じくらい結果を変えます。
10 · Not Wired In
サービスにはすぐにつないでいません
このツールはStyleRoomのサービスとは別に置いてあります。学習が終わって成果物が出ても、それがフィッティングショットやスタイルショットに自動で入ることはありません。つなぐには、人が別途作業をする必要があります。
作りながら、当然この疑問が出てきました。学習が終わったなら、すぐにサービスで使えるべきではないのか。
そのためには、成果物をどこにどうつなぐかを前もって決めておく必要があります。フィッティングショットに付けるのか、スタイルショットに付けるのか、セラーが選んでオンにするのか、ブランドごとに自動で付くようにするのか。
でも、それを決めるには何を学習させるのかを先に知っている必要があります。ブランドの着こなしを学んだもの、背景を学んだもの、商品説明の文章を学んだものは、付く場所がすべて違います。まだ何を学習させるかわからない状態で接続から作っておくと、今回もまたその接続が学習の方向を決めてしまいます。
先ほど文章テンプレートを作らなかったのと同じ話です。今回はそれがツールの中ではなく、ツールの外で起きます。付ける場所を1つ作っておくと、それ以降はそこにはまる学習しかしなくなります。
そこで順番をひっくり返しました。
01学習を回す何を学ばせるかはその都度決めます
02結果を見る使えるかどうか、どこで使えるかを見ます
03そのときに接続を作るその結果に合った通り道を1本作ります
接続を前もって備えた機能として置くのではなく、学習が1つ成功するたびに1本ずつ作るものにしました。こうすると接続ができるのは遅くなります。その代わり、使わない接続を先に作っておき、そこに実験を合わせることがなくなります。
別にしておいたおかげが、もう1つあります。実験は失敗するのが普通です。条件が間違っていてかけ直し、結果がひどくて捨て、同じものを20回回します。これがサービスの動いている場所と混ざっていると、かけるたびに慎重になってしまいます。慎重な実験は、たくさんは回せません。
11 · What We Take
まとめると
ツールを作りながら学んだことが1つあります。便利さのために入れた項目が、あとで実験をふさぎます。「これは評価専用」のように、そのときは当然に見えるものが、次の実験では越えられない壁になります。
だからこのツールは、あまり決めすぎない方向で作りました。何がよい学習なのかまだわからないうちは、ツールが答えを決めないほうがいい。これまでの4本に書いた結果はすべて、その中で何度も直してはかけ直して出てきたものです。