これまでの3本は写真の話でした。巨大モデルが知らないシルエット、次々と生まれるフィットの名前、ブランドのルックブックを学習させた結果。今回は写真ではなく、文章の話です。
00 · Where It Started
スタイルルームでセラーが服をアップロードすると、次のように進みます。
ここでつまずく場所は決まっています。フィットです。服はバルーンフィットなのにワイドで出てきたり、クロップ丈なのに足首まで伸びてしまったりします。
直し方は二つあります。
文章を直す:02で書かれた説明文を直して、作り直します。
写真を直す:すでに出た写真の、その部分だけを手直しします。
文章を直すほうは、指示がなかなか効きません。「裾が足首から3センチ上」のように数値で書いても、モデルはそのとおりに描きません。そのため、文章を少し直しては作り直し、また直しては作り直すことになります。
写真を直すほうは別に作っています。この記事は説明文の側の話です。
説明文を直すには、まず知っておくべきことがあります。今その文章がどれくらい合っているのか。そして、それを毎日すでに採点している人たちがいました。
セラーが服をアップロードすると、モデルが商品説明を書きます。そしてセラーがその下書きを見て直します。直した記録はそのまま残ります。下書きが何だったのか、人がそれを何に変えたのかがペアで残るのです。
モデルが何を見誤ったのかを、人が毎回指摘してくれた記録です。だから開けてみました。
開けてみてわかったことが二つあります。
一つ目。写真に写るものは、すべてその説明文から出てきます。フィットも、靴も、何と合わせて着るかも、そこで決まります。ブランド名や型番まで書けば、そのとおりに出てきます。だから、その文章をうまく書けるようにすることは、そのまま写真をうまく作ることなのです。
二つ目。モデルが何を間違えるかは、バージョンが変われば一緒に変わります。ですから学習は、今のこのモデルのミスを直す方向ではなく、どのモデルを使っても私たちの言葉で書かせる方向であるべきです。
以下は、その二つがどうやって出てきたかです。
01 · The Request
スタイルルームには、セラーがリクエストを書き込む欄が別にあります。こう仕上がってほしいということを書いてもらうために、私たちが用意した欄です。作ったとき頭にあったのはフィットでした。つまずくのはそこですから。
そこに実際に何が書き込まれているのか、24,226件を分類してみました。
| 何をリクエストしているか | 割合 |
|---|---|
| 靴 | 44.1% |
| 色 | 44.1% |
| 丈 · フィット | 26.0% |
| アクセサリー | 25.9% |
| インナー · レイヤード | 12.6% |
| 着こなし方 | 11.0% |
| ヘア · メイク | 8.2% |
1件で複数のことをまとめてリクエストするため、合計は100%を超えます。
最も多く出てきた言葉は「靴は」(신발은)で、4,268回でした。そしてフィットは26%で4番目です。
フィットのために用意した欄なのに、人がいちばん手を入れたがっていたのは靴でした。フィットだけにこだわっていると、人が実際に手を入れたいものの3分の2を見落とします。
靴が1位なのには理由があります。靴はセラーがアップロードするものではありません。届くのは服の写真1枚だけなのに、仕上がった写真には足先まで写ります。その部分を私たちが埋めているので、セラーからすれば、ここに書く以外に手を入れる方法がないのです。
そのため、こんなふうに書いてきます。
リクエスト欄に書き込まれるもの
「白のコンバースを履かせて、全体的にゆるっとした雰囲気になるよう ゆったりしたフィットにして。モデルはお団子ヘアで」 「グレーのアンクルソックスにバレンシアガのトラックサンダルを着用。」 「靴はビブラム ファイブフィンガーズ パフォーマ ジェーン エボ トリプルブラックを履かせて」
ブランド、ライン、モデル名、色まで、4段階で指定しています。スタイルをざっくり伝えているのではなく、商品を指定しているのです。
02 · It Works
リクエスト欄を眺めていて、目に留まった一文がありました。190着に、まったく同じ文が付いていたのです。
一文字も変わらないまま190着に
「靴はコンバースのチャック70 クラシック、ブラックを履いています。」
ブランド、ライン、モデル名、色。商品ページから写してきたような文です。そこで気になりました。こう書けば、本当にその靴が出てくるのか。仕上がった写真を取り出して、1枚ずつ見てみました。
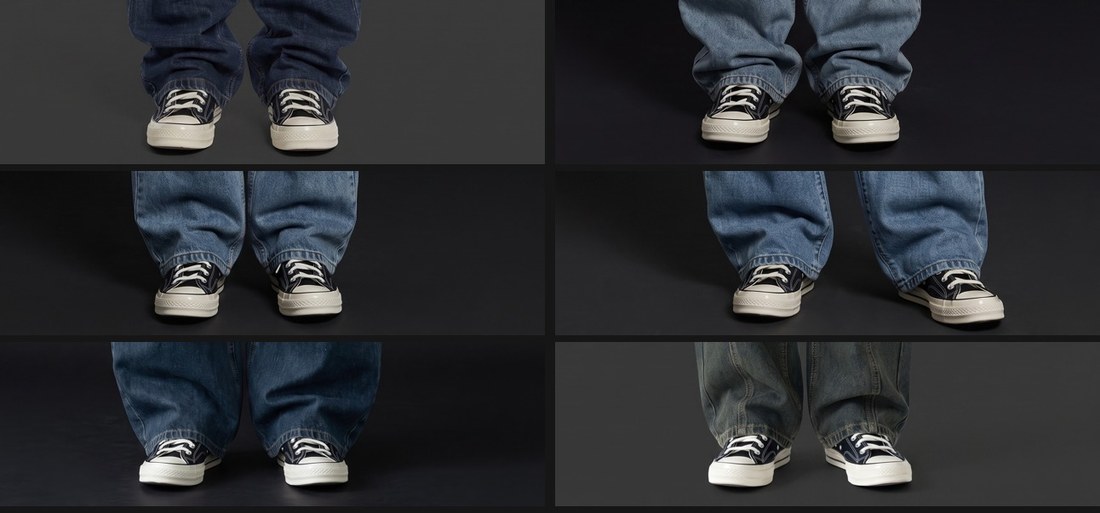
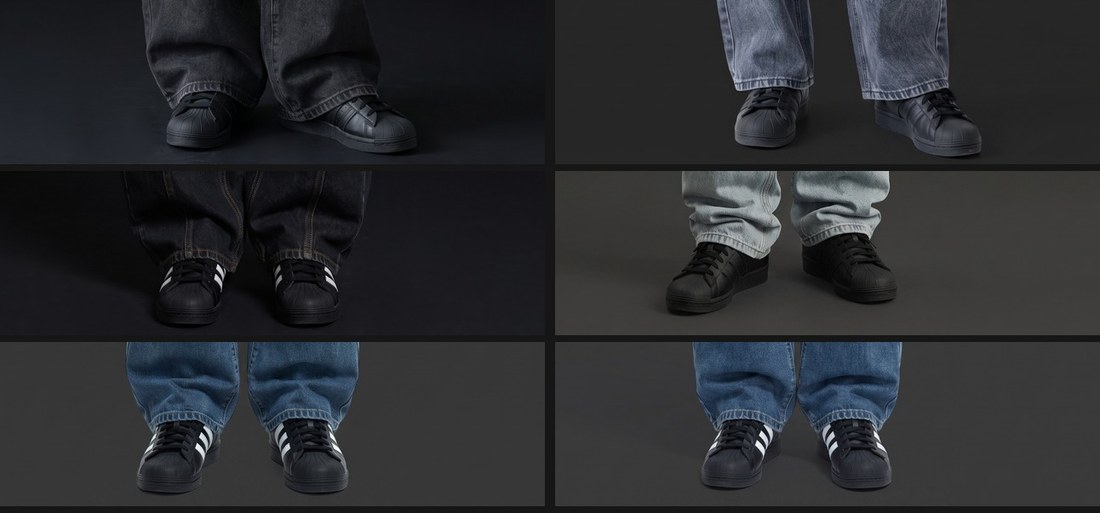
さらに確かな例もありました。アップロードした服の写真で、すでに別の靴を履いていたリクエストが2件あったのです。
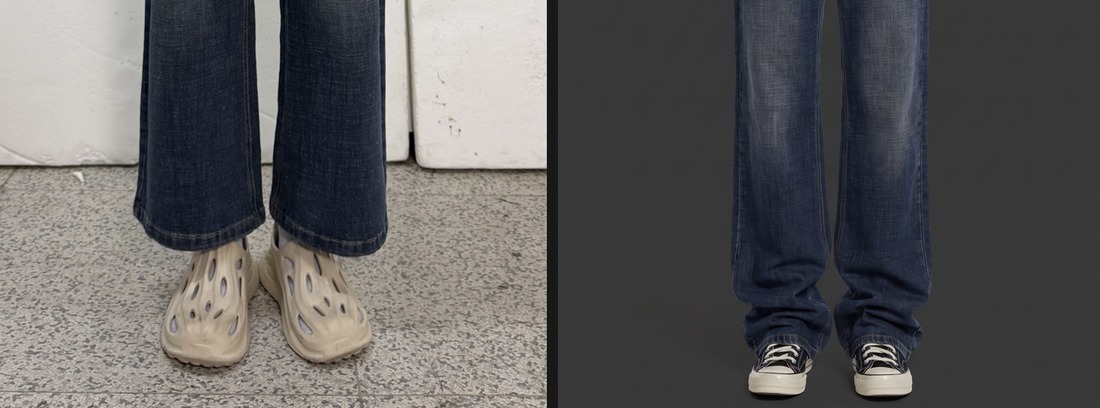
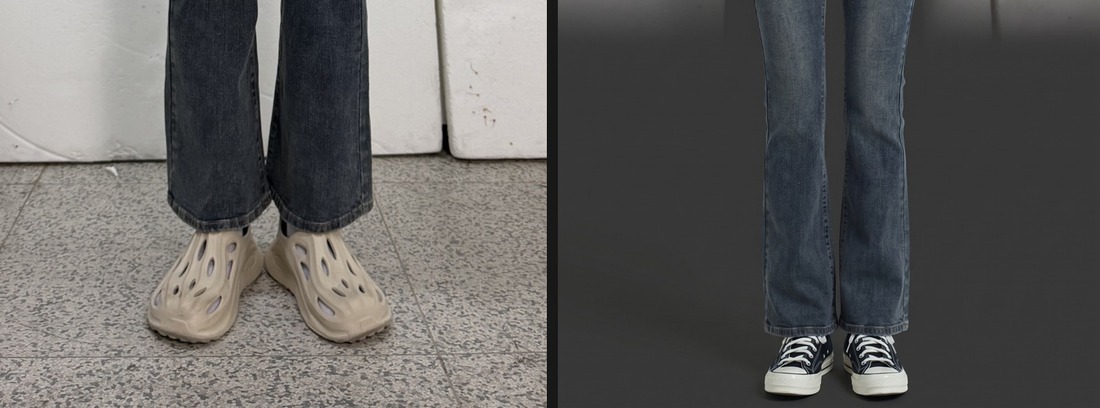
もしかして写真を見て書き取っただけではないかと思い、自動で書かれた説明文30枚を調べました。コンバース · チャック70 · スーパースターは0件で、16枚中14枚は服の写真に靴がまったく写っていませんでした。この言葉は人が入れたものです。
つまり、ここでうまくいっていないのはブランドの再現ではありません。それはできています。できていないのはこちらです。一度うまくいったその文が、私たちの側に残っていないのです。セラーがどこかに書き留めておいて、毎回貼り付けています。だから190着で文字がまったく同じなのです。
しかも、この二つの文は一人のものではありませんでした。複数のアカウントにまたがっているのに、作成時刻が互いに近いのです。一つのところで一緒に使っているということです。
ここに必要なのは、より良いモデルではなく保存ボタンです。うまくいった文を保存しておき、次の服にそのまま載せること。そしてそれは一人のものではなく、一つのチームで共有するものであるべきです。
03 · Absolutely
リクエスト欄に入ってきた言葉をもう一度見直すと、目に付く言葉があります。
「絶対」が付いた箇所
「Tシャツをパンツの中に入れないで、絶対」 「パンツ丈とタイの丈は絶対長く出力しないこと」 「必ずファッショングラビア並みの誇張した超オーバーサイズの比率を適用し、 一般的なワイドパンツのように生成しない」 「必ずボタン3つをすべて留めます」
「絶対」は、一度もうまくいかなかったときに出てくる言葉です。最初からできることに「絶対」と書く人はいません。この言葉が付いた箇所こそ、何度も失敗した箇所なのです。
04 · The Default
ここまでは、セラーがリクエスト欄に書いてくる話でした。ここからは逆側です。AIが書いた下書きをセラーが直した記録です。
フィット項目で直されたものを取り出してみると、直される前の文がどれも同じです。
| AIの下書き | セラーが変えたもの |
|---|---|
| レギュラーフィット | セミオーバーフィット |
| レギュラーフィット | ルーズフィット |
| レギュラーフィット | ゆとりのある身幅と丈感のルーズフィット |
何件か選んだのではなく、全件を数えました。
⚠️ この数字の大部分は、今使っているモデルではなく、その前のモデルから出たものです。なぜそう書くのかは次の節でお話しします。
では、セラーは何に変えているのでしょうか。
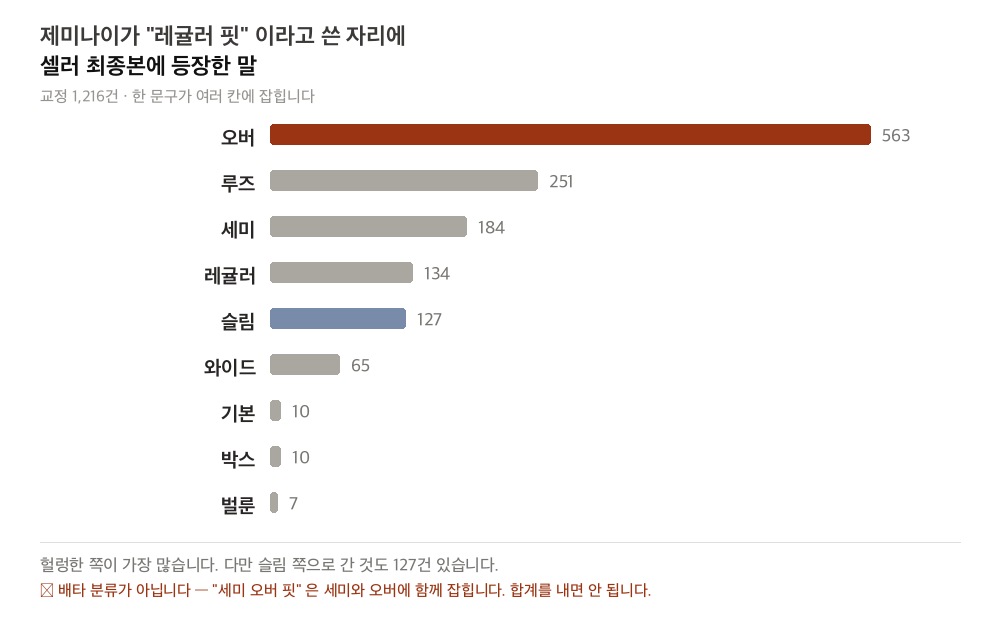
オーバーが563件でいちばん多く、ルーズが251件です。ただし、スリム側に行ったものも127件あります。いつもゆったりした側に間違えるのではなく、真ん中を選んでおいて、実際の服は両側に散らばっているのです。ゆったりした側のほうが多い、というだけです。
ところが、これを調べている間にある出来事がありました。
05 · It Moved
最初に見つけた癖は、これとは少し違っていました。AIが両天秤にかけていたのです。「レギュラーまたはルーズ」「レギュラー/オーバーサイズ」のように両方を書いておき、セラーが片方を消す、という形でした。
その癖を測ろうと実験を組んで、何枚か回してみました。出てきませんでした。プロンプトはそのままなのに、結果が変わっていたのです。その間に、下書きを書くモデルが新しいバージョンに切り替わっていました。
モデルが切り替わる前 → 切り替わった後
下書きに「または」(또는)が入った文書 60.1% → 2.4% 下書きに「レギュラー」が入った文書 29.8% → 4.5%
両天秤はほぼなくなりました。レギュラーフィットは減りましたが残っていて、残ったものの中では今も1位です。前の節の数字の大部分が切り替わる前のモデルから出ている理由はこれです。数え終わってみたら、数えていた対象の半分ほどが変わっていたのです。
特定のモデルの特定のバージョンが何を間違えるかを掘り下げると、そのモデルが変わった瞬間に積み上げたものが消えてしまいます。
ですから学習をするなら、目標はこうあるべきです。「このバージョンのこのミスを直すこと」ではなく、どのモデルを使っても私たちの言葉で書かせること。
モデルは変わり続けます。より良いものが出れば乗り換えます。そのたびに調べ直し、学習し直さなければならないなら、それは資産ではありません。
モデルは確信がないとき、「レギュラーフィット」と書きます。間違いでも正解でもない、真ん中の値です。そして実際の服は、たいていそれよりゆったりしています。
前回の記事で、セラーはセミオーバーフィット(세미오버핏) · ハーフバルーンフィット(하프벌룬핏)のような言葉を作って使うのに、モデルはそういう言葉を一度も使ったことがないと書きました。同じ話です。両端を知らないので、真ん中にとどまるのです。
06 · What The Photo Shows
修正22,608件を一つずつ開いて、この修正は写真を見ればわかることなのかを判定しました。人が写真と修正を並べて判定したものです。
ところが、この割合は項目ごとに大きく違います。
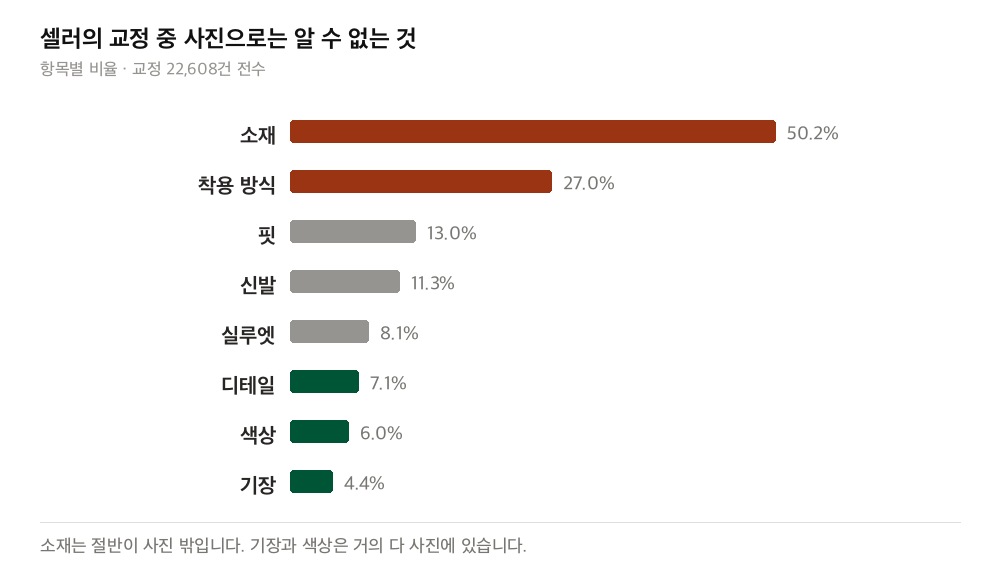
分かれ目は素材です。丈と色はほぼすべて写真にあります。素材は半分が写真の外です。繊維が何かはタグを見ないとわかりませんし、寸法はメジャーで測らないとわかりません。
写真ではわからない修正
AI リブ(ribbed)ニット素材 セラー ポリエステルおよび綿混素材 AI 綿混素材と思われ セラー リネン生地を使用しており AI クロップ丈でウエストラインより上に… セラー 身幅47cm、着丈51cm
これはモデルが見落として間違えたのではありません。写真にない情報なのです。どんなに良いモデルを使っても、写真だけを渡せば当てられません。セラーは実物を手に持っているのでわかるのです。
どれほど写真にない情報なのかは、戻ってきた値を見るとわかります。下書きに「綿混素材と推定され」と書かれた箇所を、19人が19通りに書き換えていました。
同じ箇所に入った値
レーヨン素材と推定され 綿リネン混素材と推定され ポリ100%素材で 光沢のないウォッシュ加工の綿100%素材 COTTON 43% / POLY 52% / SPAN 5%
「写真の外」というのは、わからないから空けておくという意味ではありません。書くことは書きます。ただ、毎回違う答えが正解なのです。
モデルは確信がないと、それを文に残します。上の例の「綿混素材と思われ」がそうです。「…と思われ」「…と推定される」が付いた箇所を集めると、写真では解けない項目がどこなのかが見えてきます。モデル自身が印を付けていたようなものです。
ところが、この印は素材だけに付くわけではありません。
個数を直したもの:66件
AI 6つのボタン → セラー 4つのボタン AI 2つのジップポケット → セラー 1つのジップポケット AI 2つまたは3つの小さなボタン → セラー 3つの小さなボタン
最後のものは、数えかけてやめた文です。「レギュラーフィット」とまったく同じ振る舞いですが、ボタンは数えられるものです。写真にすべて写っていて、指でなぞれば答えが出ます。写真の外だから当てられなかったのではありません。
07 · Both Ways
そこで分けてみました。下書きに書かれた一つの表現について、複数の人がそれぞれ違う値に書き戻した箇所を集めました。713種類が出てきて、内訳はフィット199 · 丈143 · 素材141 · ディテール115 · 色92です。分かれるのはフィットだけではありません。
その中から、AをBに直したものもあれば、BをAに直したものもあるペアだけを抜き出しました。最も大きいのがこれです。
両方向の原文
ブラック → ネイビー 黒の地 → ネイビーの地 深く濃いネイビーブルーの色 → 黒の色 ダークネイビー(Dark Navy) → ブラック
53対44であることが重要です。片方に偏っていれば、それは癖です。紺をつい黒と書いてしまうということなので、そう書かないように言い聞かせればいい。ところが両側がほぼ同じなら、それは癖ではなく二つを見分けられないということです。コイン投げと同じです。
白とアイボリーも同じところで崩れます。そしてこれは色だけの話ではありません。
ストライプの向き:5件、両方向に分かれる
AI 縦ストライプ柄が際立つ長袖 セラー 横ストライプ柄が際立つ半袖 AI 横ストライプ柄 セラー 縦ストライプ柄
色や素材なら、「写真では難しいだろう」と流すこともできます。ストライプの向きは誰の目にも見えます。それなのに両方向に間違えます。5件なので割合で語るものではなく、こういうことがある、というところまでです。
フィットの中にも、二つの性質が混ざっていました。
| ペア | 片方 → もう片方 | 性質 |
|---|---|---|
| レギュラーフィット ↔ ルーズフィット | 18 : 3 | 癖 |
| ルーズフィット ↔ オーバーフィット | 7 : 1 | 癖 |
| レギュラーフィット ↔ オーバーサイズフィット | 4 : 3 | 見分けられない |
| レギュラーフィット ↔ ワイドフィット | 4 : 3 | 見分けられない |
先ほど「わからないとレギュラーと書く」と書いたのは、18対3のペアです。これは確かに癖です。ところが同じレギュラーでも、オーバーサイズやワイドとぶつかると4対3になります。一つの項目の中に、直せるものと直せないものが一緒に入っているのです。
この区別が必要なのは、手の打ち方が違うからです。癖は言葉を変えてあげれば減ります。見分けられないものは、言葉ではどうにもなりません。実物を持っている人が教えてくれる以外に方法がないのです。
この計算は、タガーが抜き出しておいた下書き原文の断片を軸にしており、断片が両側とも残っている12,741件が母数です。ペアを数える際は単語辞書を使わず文字だけで突き合わせたため、実際のペアはこれより多くなります。人数はアカウントではなく、人単位にまとめて数えました。
08 · The Trap
ここまで見ると、次の一手は明らかに思えます。間違った文と直された文がペアで積み上がっているのだから、それを学習に入れれば、モデルは直し方を覚えるのではないか。
ところが、まずどれくらい直しているのかを見るとこうなります。
| 1文書の中で直した度合い | 文書 | |
|---|---|---|
| 手を入れていない | 207 | 1.35% |
| 5%未満 | 7,185 | 46.98% |
| 5〜20% | 5,714 | 37.36% |
| 20〜50% | 1,697 | 11.10% |
| 50%以上 | 490 | 3.20% |
セラーが1文書の中で手を入れるのは5%ほどです。残りの95%は、モデルが書いた文がそのまま出ていきます。すると学習はこう計算します。下書きをそのままにしておけば95%は正解。直そうとして間違えるより、直さないほうが点数が高いのです。
私たちは修正記録を集めたつもりでしたが、その中身の大部分は承認記録です。セラーが読んで「このまま出していい」と判断した文が圧倒的に多いのです。その承認が多数である限り、データを増やしても長く回しても、モデルは写し続けるほうが得です。
そこで方向を変えました。すべての文を同じように学習させるのではありません。セラーが実際に手を入れた箇所に重みを置き、そこを間違えたときにはずっと大きく間違えたと見なすようにします。95%の承認された文は軽く通り過ぎ、5%が学習を引っ張るようにするのです。
09 · What It's Really For
この記事はテキスト学習の話として読めるかもしれませんが、それはいくつかある道筋の一つです。やろうとしていることは最初の場所に戻ります。服をアップロードしたときに出てくる、あの2枚をもっと良くすること。
先に見たとおり、写真に写るものはすべてその文章から出てきます。フィットも靴も、何と合わせて着るかも、そこから出てきます。そして同じものをどんな言葉で書くかが結果を変えます。センチメートルで書くとそのとおりには描きませんが、体のどの位置まで来るかで書くと描くのです。
セラーが丈を直しながら新しく書き入れた表現を、体の上から下へ並べてみるとこうなります。
| セラーが指定した位置 | 件数 |
|---|---|
| 骨盤まで · 骨盤を少し覆う · 骨盤の下 | 72 |
| 太ももの中ほど · 太ももまで | 79 |
| 膝上 · 膝まで · 膝を覆う | 49 |
| 膝下 | 52 |
| ふくらはぎの中ほど · ふくらはぎまで | 43 |
| 足首の上 · 足首まで · 足首を覆う | 67 |
| 足の甲を覆う | 62 |
| 靴を少し覆う · 靴の上 | 16 |
センチメートルは出てきません。代わりに体の位置を指定して、そこに程度を載せます。少し397 · もっと395 · とても215 · すごく203。「骨盤を少し覆う」のように、位置と強さがひとかたまりでくっついています。
「もっと」(더)がこれほど多いのも注目すべき点です。今よりもっと長く。決まった値ではなく、たった今出てきた写真を基準にした言葉です。人は絶対的な長さで考えるのではなく、画面に出たものからどれだけ動かすかで考えるのです。
丈はこのように、8つか9つで一覧が出来上がります。骨盤から靴の上まで、体に沿って順番に並びます。ところが身幅やシルエットは一覧になりません。同じ資料で「フィット」で終わる表現が196種類出てきて、よく使われる順に30種類を入れても69.2%しかカバーできません。残りは一覧にない言葉です。前回の記事でお話ししたあの話です。
そこで今取り組んでいるのがこれです。人が毎回手で直して書き入れているその表現を、最初から出てくるようにすること。テキスト学習はその方法の一つで、スロットを分けることもプロンプトを直すことも、目的は同じです。
10 · What We Take
| 問い | 答え |
|---|---|
| リクエスト欄に人は何を書いてくるか | 靴44% · 色44% · フィット26%。フィットは4番目です |
| 文字で書けばそのとおりに出るか | 出ます。ブランドの靴12枚すべて合っていました |
| では何が妨げているのか | うまくいったその文が、私たちの側に残っていません |
| モデルは確信がないとき何を書くか | レギュラーフィット。セラーがそれを消します |
| その癖はこの先も続くか | いいえ。モデルが変われば消えます |
| 写真だけでは無理な項目はあるか | あります。素材がそうです |
| 間違いはすべて同じ種類か | いいえ。癖と見分けられないものが混ざっています |
| 修正記録をそのまま学習に使えるか | いいえ。直さない方法を覚えてしまいます |
| セラーが直したものはすべて誤りの訂正か | いいえ。写真と違っても、そうしたいのです |
この記録が役に立つのは、モデルがどこで揺らぐのかを人が直接指し示してくれている点です。どの項目が写真で解けて、どの項目が解けないのかが残っています。
ただ、データが多いことがそのまま学習になるという意味ではありませんでした。積み上がったものの中で私たちに必要だったのは、人が手を入れた部分でした。残りは、モデルをその場に縛りつけておく重りでした。
そして、セラーが直すものがいつも「間違いを正すこと」だとも限りません。
写真とは違うものに変えたもの
AI シルバーのクロスペンダント → セラー シルバーのハートペンダント AI ほどよい深さのVネック → セラー クラシックなラウンドネック AI 短めのクロップ丈です → セラー 標準丈です
どれも写真にしっかり写っているものです。素材や寸法のように、実物を見ないとわからない情報ではありません。こうしたものが1.94%あります。
最初はこれを、セラーが間違って直したものだと見ていました。でも、そうではありません。十字架をハートに変えたいのです。写真を正確に書き写すことが目的ではなく、望む写真を得ることが目的なのですから。ここには正解も不正解もありません。
そう考えると、この資料の性格があらためて見えてきます。これは写真の正解ではなく、セラーの意図です。そして意図は写真のどこにも入っていません。実物を見てもわかりません。セラーの頭の中にあって、私たちに届くのはすでに直された結果だけです。
これがこの記事全体を貫いています。素材は19人が19通りに書き、黒と紺は両方向に分かれました。正解が一つではないからです。同じ写真を前にしても、人によって望むものが違うのです。
ですから、やるべきことは決まっています。写真から引き出せるものはできるだけ正確に引き出し、写真からは出てこないものは、セラーが一度言えば次からは自動で載るようにすること。02節の保存ボタンは、その話でした。
この記事は写真が出る前の話でした。服を読み取って書く、あの商品説明文をうまく書けるようにする側です。すでに出た写真を手直しする側は別に作っています。どちらにしても、やりたいことは一つです。セラーが気に入る1枚を手にできるようにすること。
そしてスタイルルームは、これからもこうした実験を続けます。ブランドをもう一つ学習させ、セラーの修正でもう一度回し、結果が出なければ条件を変えてまた回します。
そうしているうちに、必要なものが出てきました。学習を1回回すには、どの資料を使うかを選び、それをセットにまとめ、1枚ずつキャプションを付け、パラメータを決め、何ステップ目で取り出すかを選ばなければなりません。セットは一度まとめておけば、ずっと使います。同じセットを今回は学習に入れ、次は検証に使い、条件だけを変えてまた回します。一つ変えるだけで結果が変わりますが、何のせいで変わったのかは、前に回したものと並べてみないと見えません。これを毎回手作業でやっていると、実験は積み上がらずに散らばってしまいます。
そこで、セットを積み上げておき、条件だけを変えて回し、出てきた結果を並べて見るツールを別に作りました。LoRA Lab(ローララボ)と呼んでいます。次の記事でその話をします。