StyleRoomがセラーの皆さんにお届けしているのは「この服を着た写真」です。服の写真をアップロードすると、モデルが着用した着用カットができあがります。
商品詳細ページに載る写真なので、守るべき基準がひとつあります。写真の中の服が、実物と同じでなければなりません。
ところが、ある種の服では同じことが何度も起きていました。
01 · The Balloon
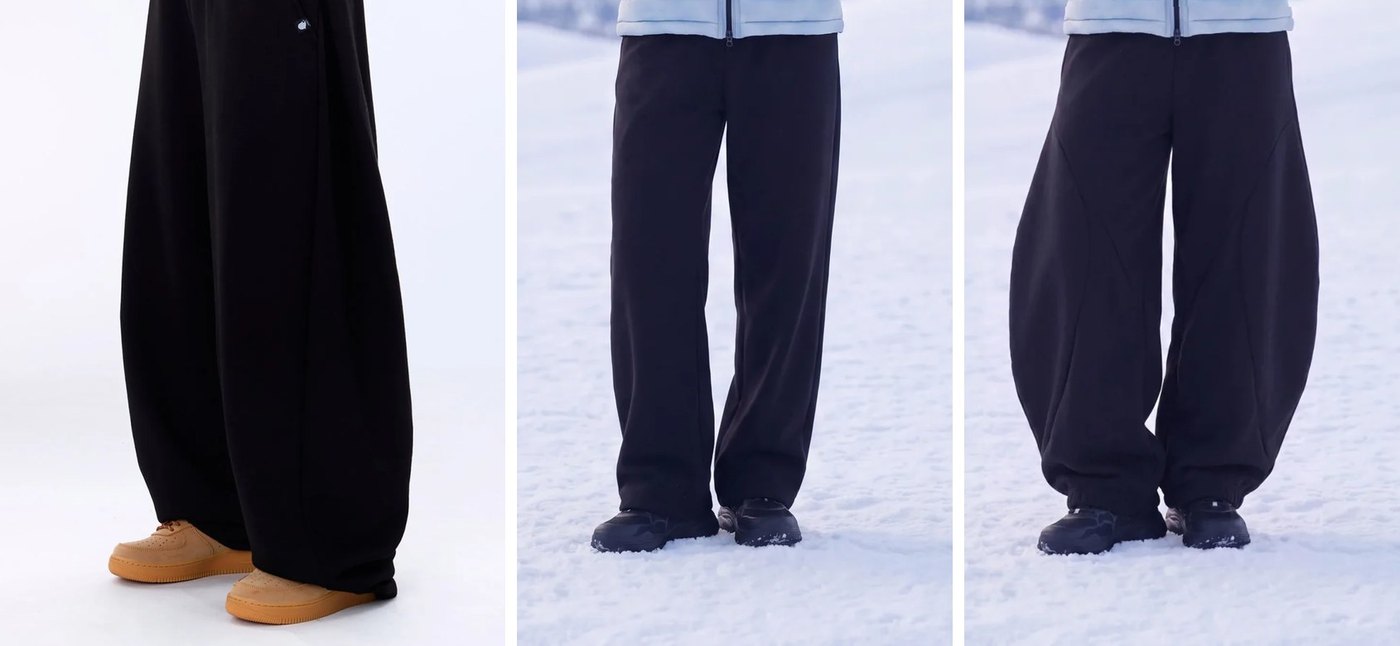
色は合っています。素材感も合っています。丈も足首まであって合っています。シルエットだけが違うのです。
しかも、ずれる方向はでたらめではありません。よくあるパンツのほうへ寄っていきました。同じことがコクーンシルエットでも、極ワイドでも、膝下丈のクロップドでも繰り返されました。どれも極端な形がほどほどの形に収束していたのです。
セラーの皆さんは、この違いにひと目で気づきます。そして形はほかの要素では埋め合わせられません。色と素材がどれだけ良くても、シルエットが違えばそのカットは使われません。
02 · Never Seen
なぜ形だけがずれるのでしょうか。答えは、モデルが何を見て育ったかにあります。
巨大モデルが学んだのはインターネット上の平均的な服です。ほとんどのパンツは脇線がまっすぐで、幅はほどほど、シルエットは体に沿っています。バルーン・コクーン・極ワイドは、その中にほとんどありません。一部のデザイナーズブランドにしかない形だからです。
描けないのではなく、知らないのです。辞書に載っていない単語を発音してと頼むようなものです。そして、この一点でほかのことも説明がつきます。
平均の中にあるからです。黒いスウェット生地も、ゴムのウエストも、インターネットにはあふれています。モデルがすでに知っているものなので、呼べば出てきます。
極端な形ほど、例がありません。そのため結果は知っているものの中でいちばん近いところへ引き寄せられます。バルーンを頼めばストレートが、極ワイドを頼めば「ほどよく広め」が出てきます。上の写真の中央が、まさにそうして出てきた結果です。
03 · The Words Were There
結果が合わないと、まず説明文を疑いたくなります。そこで、その服の説明文を開いてみました。最初の一文はこうでした。
太ももから裾まで曲線を描いてたっぷりと落ちるバルーン(壺型)フィットで、立体的で感度の高いアヴァンギャルドなスタイルを演出します。
バルーン、壺型、曲線、たっぷり(벌룬、항아리、곡선、풍성)。必要な言葉は全部そろっています。この文は画像分析が自動で書いた下書きで、セラーが確認したときに一文字も直しませんでした。人が見ても正しい説明だったということです。
その説明をそのまま入れて作った結果が、上のストレートです。
言葉はすでにあるものを呼び出すだけで、ないものを作りはしません。バルーンが指すべき視覚的な原型がモデルの中にほとんどなければ、その言葉は二十個ほどある説明トークンのひとつとして埋もれてしまいます。そして、その場所をなじみのある形が埋めるのです。
付け加えると、こうしたカットが出たときに取り戻す方法はStyleRoomの中にすでにあります。StyleRoomの部分補正機能でパンツの部分だけを指定し、同じ文をもう一度入れると曲線が戻ってきます(上の写真の右)。狭い範囲なら、その言葉が埋もれないからです。
ただしこの方法は、セラーがずれに気づき、範囲を選び、指示を入れ直してはじめて始まります。仕上がり一枚ごとに、そのやり取りが一往復ついてきます。
04 · Show, Don't Tell
言葉で伝わらないなら、例を見せて教えるしかありません。このブランドの服の写真と、その服を着た着用カットをペアにして何着分も見せ、その間にあるルールをモデル自身につかませるのです。
そして、学習でなければならない理由がもうひとつあります。ブランドごとに違う答えが必要だということです。「ルーズフィット」が指す服はブランドごとに違います。あるブランドでは肩が落ちて袖幅の広い服、別のブランドでは身幅だけゆったりして肩線は本来の位置にある服です。オーバーフィット、セミオーバーフィット、リラックスフィット、バルーンフィット、コクーンフィットと語彙をいくら細かく分けても、ブランドがひとつ増えれば、そのブランドの「ルーズフィット」もまたひとつ増えます。
必要なのはもっと良い説明ではなく、ブランドごとに別々に持つ何かです。
05 · But We Can't Build Models
学習が答えだからといって、どんな学習でもいいわけではありません。まず認めておくべきことがあります。私たちは画像生成モデルそのものを作ることはできません。
いまこの分野にいるのは、次のようなプレイヤーです。
| 開発元 | モデル | 重み |
|---|---|---|
| OpenAI | GPT Image · DALL·E | 非公開 |
| Imagen · Gemini 画像 | 非公開 | |
| Midjourney | Midjourney | 非公開 |
| Adobe | Firefly | 非公開 |
| ByteDance | Seedream | 非公開 |
| Black Forest Labs | FLUX | 一部公開 |
| Stability AI | Stable Diffusion | 公開 |
| Alibaba | Qwen-Image | 公開 |
これらはインターネット規模の画像で、数千枚単位のGPUを何週間も回して作られています。私たちには、それだけのデータもGPUも、それを支える資本もありません。追いつくこともできません。私たちが1年走る間に、向こうも走っているからです。
ただし、表の下の3つは重みが公開されています。作ることはできなくても持ってきて使うことはできるということで、ここに道が開けます。
そこで問いはこう変わります。公開されたモデルを持ってきて、その上に自分たちのものをどう載せるか。方法は3つありますが、最初の2つはうまくいきません。
先ほど見たやり方です。まさに今回のリクエストから効きません。バルーンと書き込んだそのリクエストで、ストレートが出てきました。モデルが知らない形を、言葉は呼び出せないからです。
しかも積み上がりもしません。100回説明しても、101回目にはまた一から説明し直しです。毎回効かないことを、毎回やり直しているようなものです。
公開モデルを持ってきたのだから、それを丸ごと教え直せばいいのでは。それもうまくいきません。
まず現実的な壁があります。モデル全体を教え直すにはそれ相応のGPUが必要で、ブランドごとに数十GBのモデルが1セットずつでき、新しいことを学ぶうちに元々知っていたことを忘れてしまいます。バルーンフィットは覚えたのに、シャツが描けなくなるといった具合です。
ですが、もっと大きな問題は教え方にあります。
数十着分のブランドデータでモデル全体を開いて教えると、モデルはわざわざルールを探そうとしません。その数十枚をそのまま丸暗記するほうがはるかに楽だからです。
試験範囲が100問で答えを全部覚えられるなら、誰も原理を勉強しないのと同じです。学習セットにあった服は完璧に再現するのに、初めて見る服では何もできません。私たちが欲しかったのは「このブランドはこういう曲線を使う」というルールなのに、手に入ったのは「あのパンツの写真」でした。
ここで問いをひっくり返してみます。巨大モデルが描いてくれる絵は、実はたいてい良いのです。色も素材も照明も背景もポーズも、私たちに作れるレベルではありません。ずれるのはたった一か所、シルエットだけです。
それなら、モデルを作り直す理由はありません。必要なのはこれひとつです。
上手に描いてくれるところはそのままに、フィットだけをこのブランドのものに変えられないか?
モデル全体には手を触れず、「このブランドはこういう曲線を使う」ということだけを別に書き留めておき、絵を描くときにそれだけを載せる方法です。それがLoRA(Low-Rank Adaptation)で、3つの中で唯一うまくいく方法です。次の節で、なぜそれが可能なのかを見ていきます。
06 · What It Is
「絵はそのまま、フィットだけ」を実際にどうやるのか。まずはたとえで見てみます。
モデルは絵の描き方が書かれた、とても分厚い説明書だと考えてください。服はこう、しわはこう、光はこう。そんな指示が何十億行も書かれています。これを全部書き直すのが前の節の「丸ごと教え直す」で、それはうまくいきません。
そこで説明書は一文字も直しません。代わりに、横に薄い修正メモを一枚貼ります。「このブランドのパンツは、ここでこれだけ多く膨らませる」といった差分だけが書かれた紙です。
絵を描くときは、説明書とメモを一緒に見ます。説明書どおりに描きつつ、メモに書かれた分だけ違えて描くのです。
これがLoRAです。説明書がW、メモがAとBの2枚で、学習はメモにだけ書き込みます。
sの分だけ反映して合わせて使います。s = 0ならメモを見ないということなので、原本と同じになります。メモには大事な性質が3つあります。
学習前のメモには何も書かれていません。そのため最初は原本と結果がまったく同じです。学習が進むにつれて一行ずつ埋まっていき、どれだけ埋まったかが、そのままどれだけ学んだかになります。あとで学習がうまく進んでいるかを見るときに、この値を使います。
絵を描くときに、メモをどれくらい強く反映するかを数字ひとつで決めます。これをs(LoRA scale)と呼びます。
s = 0ならメモをまったく見ません。原本そのままです。s = 1なら書かれたとおりに、s = 1.3なら書かれた内容より1.3倍強く反映します。
ここで、前の節の問題がひっくり返ります。メモが説明書と同じくらい分厚ければ、学習に使った服の写真を丸ごと書き写せてしまいます。そうなると、また丸暗記に戻ります。
メモが薄ければ、その余地がありません。数十着を全部は書けないので、それらの服に共通して現れるものだけを選んで書くことになります。それこそが私たちの求めていた「このブランドの曲線」です。
小さいから安いのではなく、小さいから学ぶのです。
メモのサイズ
途中保存ポイント
学習するのにかかる時間
07 · Ownership
メモの作り方は2通りあります。そしてこの選択が、事業の性格を変えます。
GoogleのVertex AIのチューニング機能のようなものです。私たちのデータをアップロードすると、向こうが自分たちのモデルを私たち向けに調整してくれます。手軽で、結果も良好です。
ただし、調整された結果は向こうのサーバーに残ります。私たちはそのモデルを呼び出して使えるだけで、持ち出すことはできません。
先ほどの表の下の3つのように重みが公開されたモデルを取得し、自分たちのGPUでメモを作ります。手間はかかります。
その代わり、できあがったメモファイルは私たちのストレージに残ります。私たちが選び、私たちが積み上げ、私たちが使います。
| A · チューニングサービス | B · 公開モデル + LoRA | |
|---|---|---|
| 学習は | できる | できる |
| 結果の重み | 🔴 向こうに残る | 私たちのストレージに残る |
| 私たちのデータは | 🔴 相手のモデルを良くする | 私たちの資産として積み上がる |
| 結果 | 🔴 自分たちの武器を相手に学習させる | 差が私たちの側に蓄積される |
ここで「私たちの武器」が何なのかが重要です。巨大モデルはすでに世の中に積み上がったもので学習します。服が売れ、写真が積み上がり、それが学習データになり、学習が回ってはじめて知ることができます。
新しい流れを知るまでの時間
先に服を持ってくる時間
私たちだけが持つ期間
セラーの皆さんは売れる前に服を持ってきます。サンプルを撮り、説明を直し、どのカットを使うかを選びます。その一つひとつの行動が「この服はこう見えれば売れる」という判断です。
巨大モデルが半年後に知ることを、私たちはいまセラーの皆さんの手から受け取っています。私たちが持っているのは、より大きなモデルではなくより早いデータです。そのデータで相手のモデルを改善してあげる構造なら、優位は消えてしまいます。
08 · Fit
私たちが積み上げようとしているものは、性格の違う二つです。LoRAはその両方に合う形です。
ブランドのフィットやシルエットはあまり変わりません。そのためブランドごとのアダプターが積み上がっていきます。服が増えるほどそのブランドのアダプターは良くなり、良くなるほど乗り換えにくくなります。ファイル1つがブランド1つなので、ブランドが100社になってもモデルは1つです。
いま流行っているものは、半年後には流行っていません。そのため新たに学習して差し替える必要があります。LoRAは学習が数時間でファイルも小さいので、差し替えが現実的です。丸ごと再学習する仕組みだったら、この軸はそもそも成り立ちません。
そしてこの軸は、あとから追いかけることができません。この6か月間にセラーが何を持ってきたかは、いまから集め始めても手に入りません。時間が作ったデータなので、お金で前倒しすることはできないのです。
09 · Operationally
戦略とは別に、メモ方式だからこそ実務で可能になることが二つあります。どちらもなければ実験そのものが成り立ちません。
メモを見ずに描けば(s = 0)、学習していない原本そのままが出てきます。メモを見て描けば、学習した結果が出てきます。
つまり、同じ服・同じ背景・同じポーズで「学習前」と「学習後」を並べて出してみることができます。違う条件はひとつだけなので、差が出たならそれは学習によるものです。
これがないと、結果が良さそうに見えても学習がうまくいったのか、単にその服が簡単だったのかがわかりません。
メモファイルが小さいので、学習している間に途中の状態を20回コピーしておきます。少し学んだメモ、半分ほど学んだメモ、最後まで学んだメモが20枚残ります。
終わったあと20枚を全部試して、いちばん良いものを選びます。最後まで学んだものがいちばん良いという保証はないからです。実際に、途中のもののほうが良かったケースもありました。
モデルを丸ごと教え直す方式だったら、数十GBのものを20セット保存しなければならず、こうはできません。
10 · The Handles
学習をかけるときに人が決める値です。一つずつ、どういう意味なのかを見ていきます。
学習のときに写真1枚を何ピクセルまで見て学ぶかを決めます。この値より大きい写真は縮小して見ます。小さく見れば速く学べますが、生地の織り目のような細かい情報がつぶれます。大きく見れば遅くなる代わりに、そうしたところまで学びます。
メモを何回書き直すかです。学習の総量だと考えてください。少なければ学びが足りず、多ければより多く学びますが、ある地点を越えるとかえって悪くなります(丸暗記を始めます)。
完成したメモを、絵を描くときにどれくらい強く反映するかです。学習が終わったあとに決める値なので、学習し直さずに変えて試せます。
メモの厚さです。行数が多いほどたくさん書けますが、多すぎると学習に使った服を丸ごと書き写せてしまい、丸暗記しやすくなります。ほどよく薄くしてこそ、共通点だけを書くようになります。
メモを一度直すときにどれくらい大きく直すかです。大きく直せば速く学びますが行き過ぎてしまい、小さく直せば安定する代わりに時間がかかります。
これまでの私たちの実験で、この5つがどう動いたかは次のとおりです。
| 値 | 私たちの実験では |
|---|---|
max_pixels | 結果をいちばん大きく変えました |
step | いちばん良い区間があり、越えると悪くなります |
s | 変えても結果は変わりませんでした |
r | 32で固定。64も回してみましたが、比較は残していません |
lr | 指定したことはありません。デフォルト値で回しています |
11 · Step
学習が実際にどう進むのかを見てみます。
モデルに服の写真を何枚か見せて、描かせてみます。正解(実際の着用カット)と比べて、ずれた分だけメモを少し直します。この1回が1ステップです。
手元の服すべてを一度ずつ見せると1エポックです。同じ服を何度も繰り返し見せるのですが、人が同じ問題集を何周も解くのと同じです。
服155着を16回ずつ繰り返し見せると2,480ステップになります。1ステップに8秒ほどかかるので、全体で5時間です。
写真を2倍の大きさで見て学ばせると、1ステップにより時間がかかります。学習し終えたあとに絵を1枚出す時間も、90秒から140秒に延びます。
最初に小さな写真で学習したときは、1,375ステップあたりで結果がいちばん良くなりました。そこで写真を2倍に大きくして学習し直すときも、同じあたりを見ればいいだろうと考えました。
ところが、その地点の結果はひどいものでした。写真が大きくなると一度に見るべきものが増えるので、同じステップ数でもずっと学びが足りない状態だったのです。
さらに回してみると、2,000ステップを越えてもまだ良くなり続けました。「ステップ数が同じなら同じくらい学んでいるだろう」は間違いでした。
12 · How Far
では、いまどれだけ学んだ状態なのかはどうやってわかるのでしょうか。先ほどメモは白紙から始まるとお話ししました。つまりメモに書かれた量が、そのまま学んだ量です。
メモに書かれた数字の大きさを全部合計してひとつの値にすると、学習が進むにつれてこの値は大きくなります。その値がそれ以上上がらず頭打ちになる地点が、たいていは結果がいちばん良い地点でした。
ただし、これは「どれだけたくさん書いたか」であって「うまく書けたか」ではありません。たくさん書いたのに見当違いのことを書いている可能性もあります。そのためこの値は「このあたりで結果を見てみよう」という合図としてだけ使い、良し悪しは出てきた絵を目で見て決めています。
まとめ
バルーンフィットがバルーンフィットにならない。説明が足りないからではありません。必要な言葉はすでに全部書かれていて、人による確認まで済んでいました。巨大モデルがそうした服をほとんど見たことがないため、知っている形の中でいちばん近いものに引き寄せられたのです。
知らないものは、見せるしかありません。けれども私たちは、巨大モデルを作ることも追いつくこともできません。だからそれはそのまま使わせてもらい、私たちだけが知っていることをその上に載せるのです。
LoRAは巨大モデルに勝つ方法ではなく、巨大モデルを使いながら自分たちのものを残す方法です。巨大モデルが知らない服を、私たちは毎日見ています。その服をメモに変えておけば、私たちのストレージに積み上がっていきます。
StyleRoomはこの方向に進んでいます。巨大モデルはこれからも良くなり続けるでしょうし、それは私たちにとっても良いことです。より良い絵の上に、私たちのメモを載せればいいからです。
その間に私たちは、ブランドごとにメモを一枚ずつ積み上げていきます。セラーが新しい服を持ってくるたびにそのメモは厚くなり、厚くなるほどほかでは真似しにくくなります。モデルは借りて使っていますが、その上に残るものは私たちのものです。