前の二本はフィットの話でした。言葉で指示してもうまくいかず、語彙をさらに細かく分けてもうまくいきません。そこで、ブランドの服でモデルを直接学習させてみました。
この実験を行った理由はフィットではありませんでした。フィットが引き継がれることは、以前のブランドですでに確認していました。今回確かめたかったのは、その服をどう着せるかです。
この実験で検証したかった提案
「御社のブランドを学習させておきました。」
「これからは新作が出たら、服の写真を一枚だけください。御社の雰囲気でコーディネートして、商品ページに載せるカットまでお作りします。」
ブランドは新作が出るたびにルックブックを撮影します。モデルを呼び、スタジオを押さえ、スタイリストが靴や小物を合わせます。そのブランドがこれまで撮ってきたルックブックには、そのブランドが服をどう着せるかがすでにすべて詰まっています。
結果はこうです。パンツを一枚入れると、トップスが作られ、ひと揃いのコーディネートとして出てきます。トップスは一度も入れていません。
01 · The Setup
学習は、問題と答えをペアにして入れる方式です。問題はパンツの商品カット一枚、答えはそのパンツを着用したルックブック写真一枚です。

このようなペアを114組作って入れました。服114着分ということになります。
そして、11着はあえて外しておきました。この11着は一度も学習に入れていません。学習が終わったあとでこれらの服の商品カットだけを入れ、ブランドが実際に撮ったルックブックのカットと並べて見比べます。
外しておく理由は単純です。学習に入れた服で結果を見ると、モデルがその服を覚えたのか、ブランドを学んだのか区別できません。
ただし、隣に並べるルックブックのカットを正解とは呼びません。ブランドがそのパンツで撮ったカットは何枚もあり、同じパンツに別のトップスを合わせたカットもあります。私たちの結果がその一枚と違うからといって、間違いというわけではありません。
02 · What Came Back
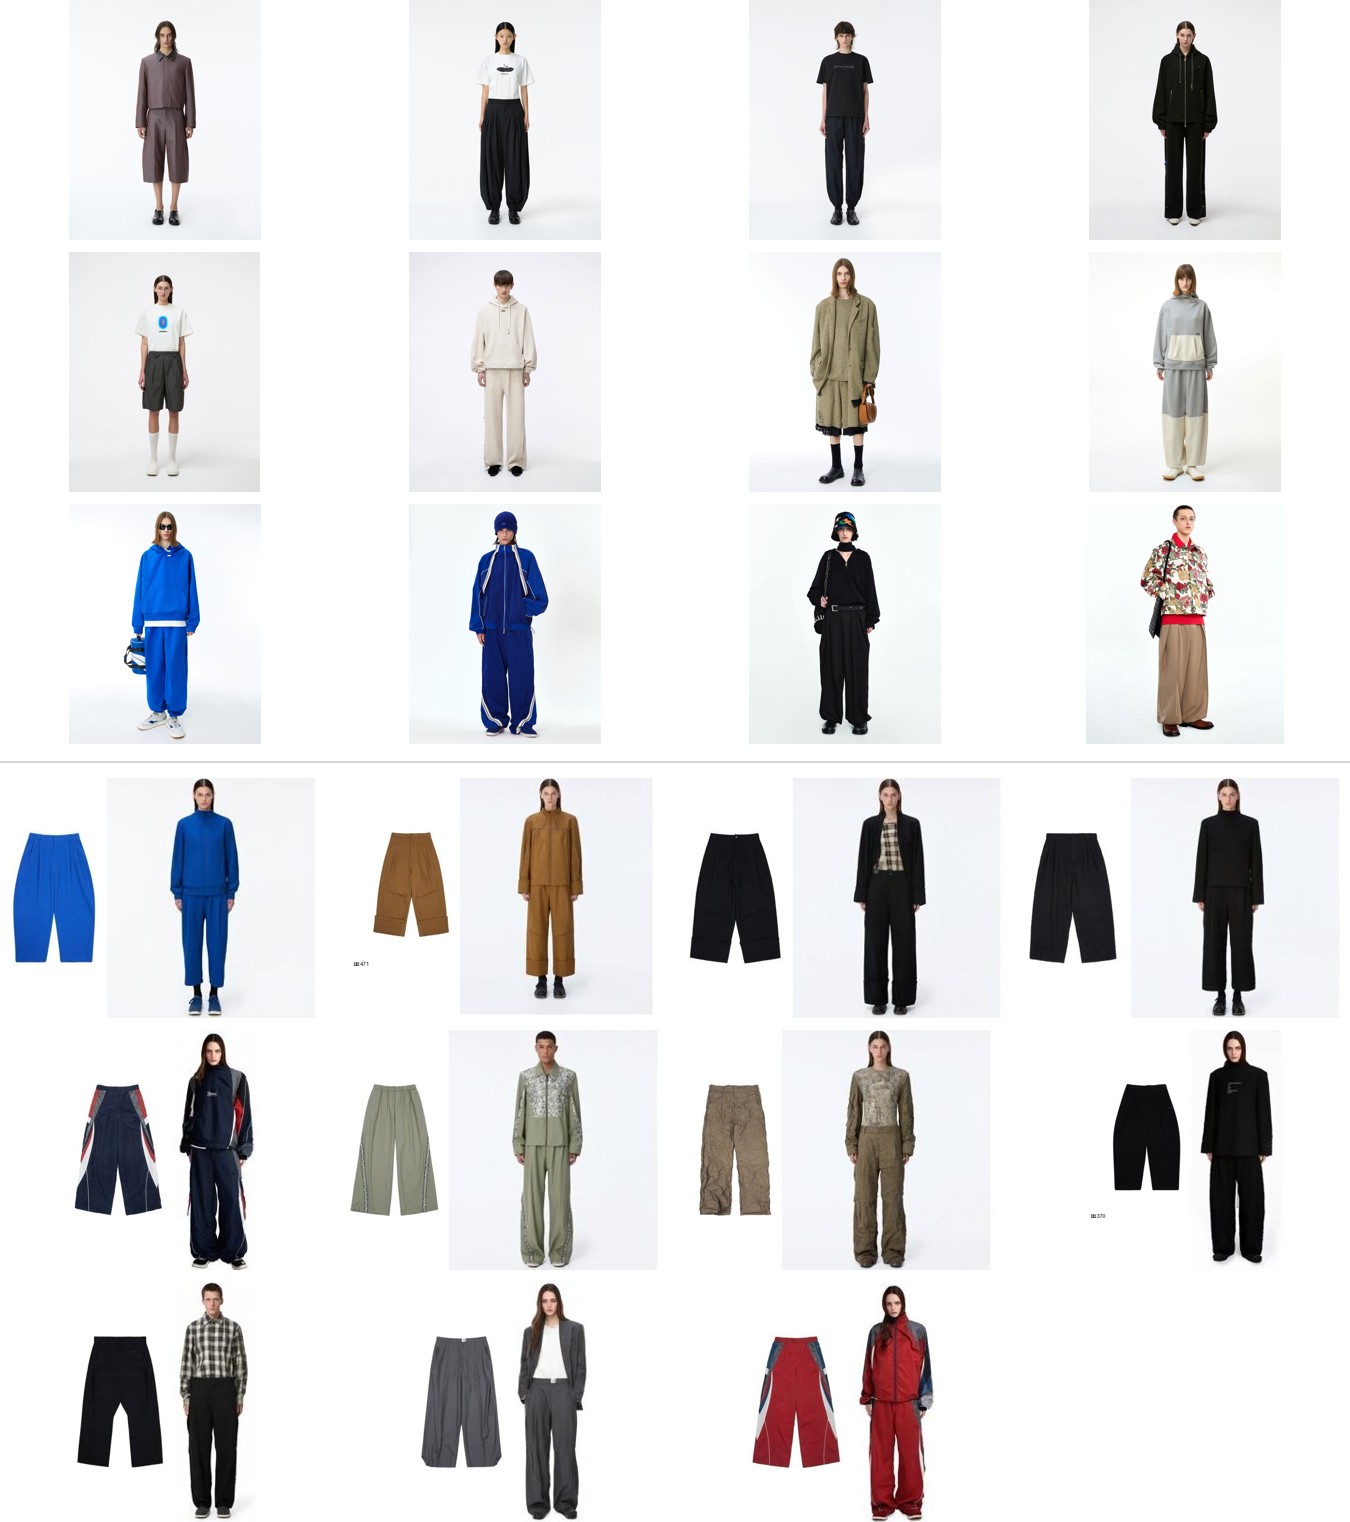
入力はパンツ一枚です。トップスを入れたことはないのに、11本すべてでトップスが作られました。適当なトップスが付いたのではなく、そのパンツに合わせて、このブランドならこう着せただろうと思える一着が出てきます。
- セットアップにまとめます:ボトムスと同じ素材・色のトップスを付けてセットにします。11本中8本がそうでした
- 配色が引き継がれます:トラックパンツの赤・グレーのパネルがジャケットにも入ります
- ディテールが引き継がれます:サイドに刺繍のあるパンツには、同じ刺繍の入ったジャケットが付きます
- 中に重ね着させます:黒いアウターの中にチェックシャツを入れたり、グレーのスーツの中に白いインナーを入れたりします
いくつかは偶然とは考えにくいものです。
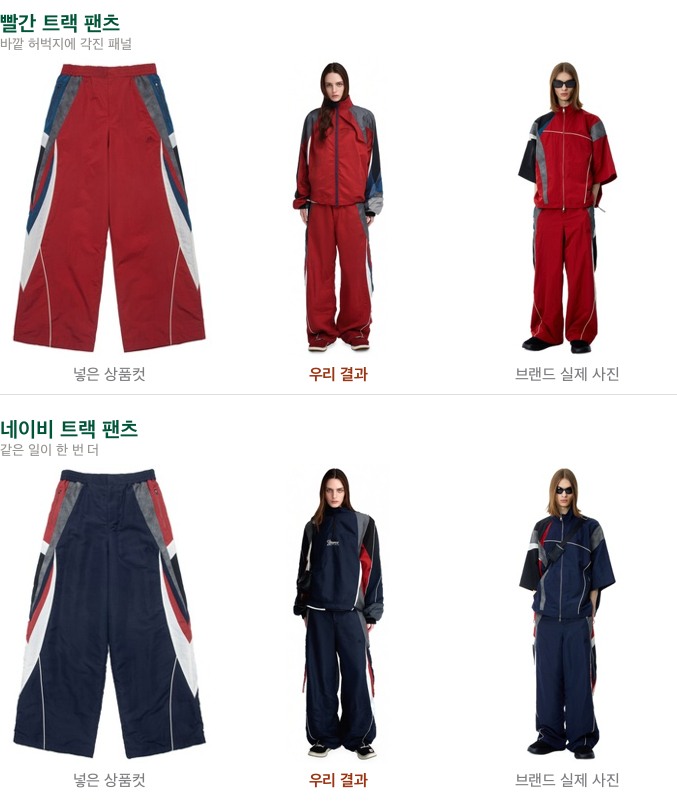
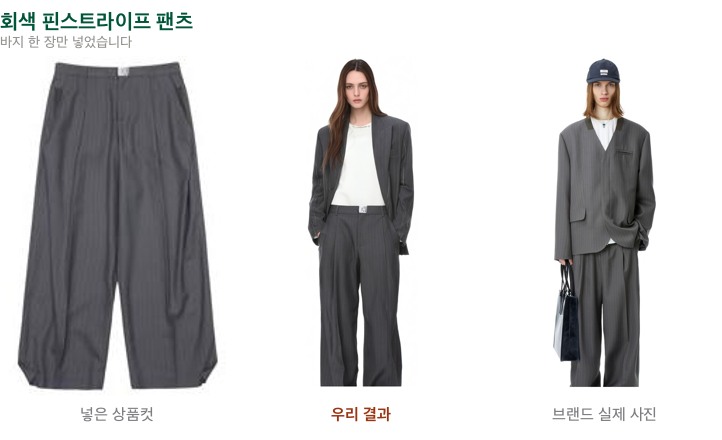
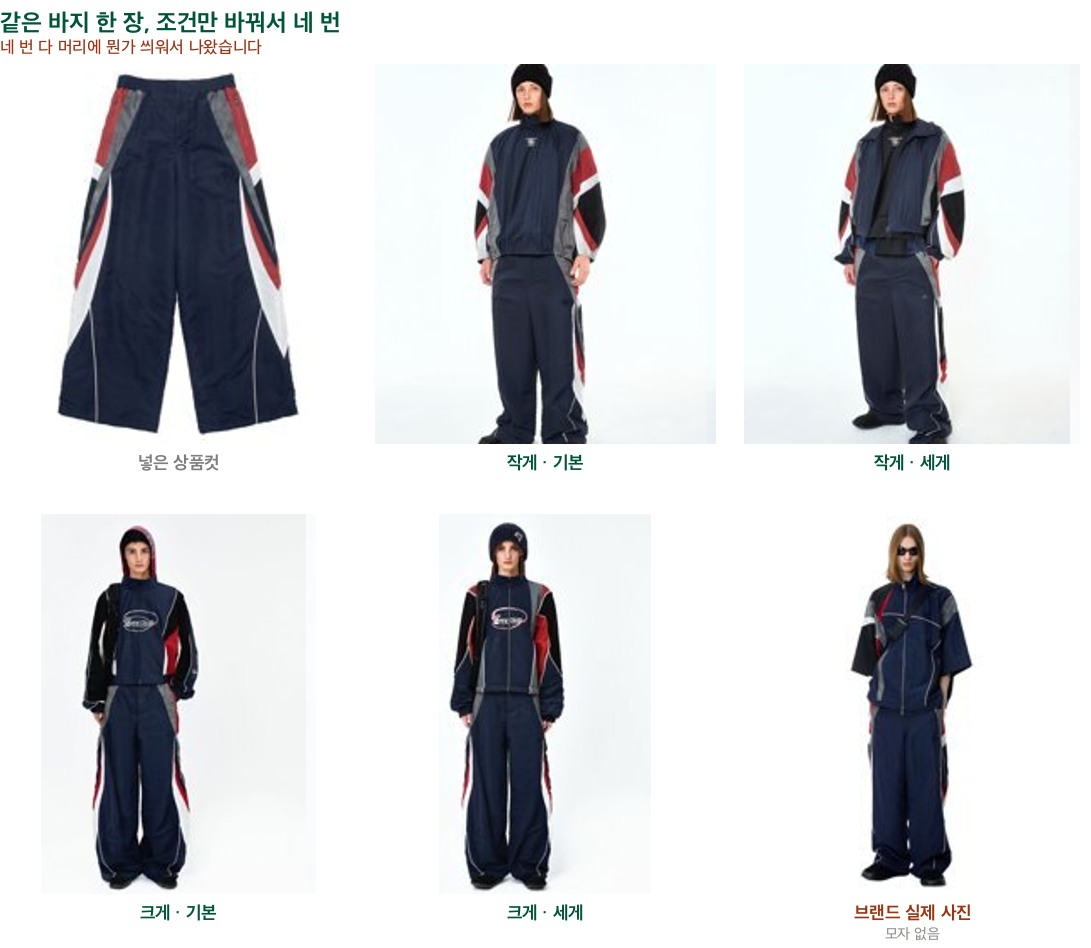
これはこの服の正解ではありません。ブランドがよくやることというだけです。ただ、条件を変えても出続けるということは、一度きりの偶然ではないという意味です。
ただし、ブランドよりもこのクセを多用します。学習に使った写真で上下を同じ生地でそろえているのは114枚中26枚ですが、結果では11本中7本がそうなっています。
03 · Where It Came From
先ほどの学習ペアを見直すと、答えがわかります。私たちが入れたのはパンツ一枚ですが、答えとして使った写真には、ジャケットも靴も靴下もバッグも一緒に写っています。ところが、その写真に付けた説明文はパンツしか記述していません。
ここでいう説明文とは、学習写真ごとに付ける一行の記述です。どんな服なのかを文章にして、写真と一緒に入れます。
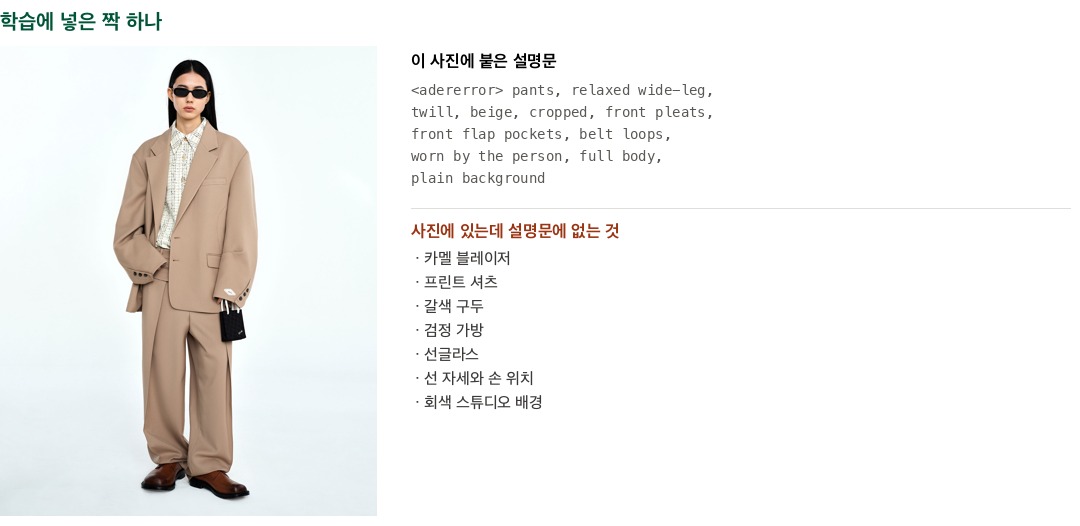
説明文に書いていないことを学びます
学習では、写真とその写真を説明する文章をペアにして入れます。モデルは、写真にはあるのに文章が説明していないものを、ブランドの特徴のほうへまとめて押し込みます。
今回の学習セットの説明文は、114本とも後半部分が一字一句同じでした。服の記述だけが違い、残りはすべて同じ文章です。そのため、コーディネートも背景もポーズまで一緒に学習されました。
04 · Alpha
ブランドらしさは出ていました。ところが、服が浮いて見えました。生地が色を塗ったように平たく出て、遠目にはそれらしく見えても、近くで見ると服に見えませんでした。
最初に考えたのはこれでした。学習したものをもっと強く効かせればいいのではないか。
強く効かせるとはどういうことか
第1回で、この方式を分厚いマニュアルの上に薄いメモを貼ることにたとえました。元のモデルはそのままにして、ブランドのルックブックから作った薄いメモをその上に重ねます。
そこで調整できる値をいくつか紹介しましたが、そのメモをどれだけ強く反映させるかを決める値がそのひとつです。1.0が基本です。上げると元のモデルから離れ、メモのほうへより強く引っ張られます。0にするとメモがまったく効かなくなり、元のモデルのまま出てきます。
1.0から1.3に上げてみました。
うまくいきませんでした。ボリュームは一貫して大きくはならず、一部の服はかえって小さくなりました。方向も一定しませんでした。適用の強さでは調整できません。学習がとらえきれなかったものは、強く効かせても出てきません。
05 · Image Size
浮いて見える原因は質感でした。学習時に写真を小さく縮めて入れていたため、生地の目のような細かい情報がその段階ですでに失われていました。
写真を大きく入れるように変えて、学習し直しました。消えていたディテールが戻ってきました。ピンストライプがくっきりし、クレープの凹凸がよみがえり、脇線のテープが見えるようになりました。

強く効かせる値ではなく、画像をどれだけ大きく見せるかが結果を変えました。
06 · Too Much
学習とは、写真を見せてモデルを少し直す作業をひたすら繰り返すことです。その繰り返し1回を「1回回した」と数えます。今回の学習は2,052回回し、その間に途中の状態を21回保存しました。
たくさん回すほど良くなるわけではありません。ある地点を越えると、毎回同じものばかり出てくるようになります。いちばんよくわかるのが靴です。
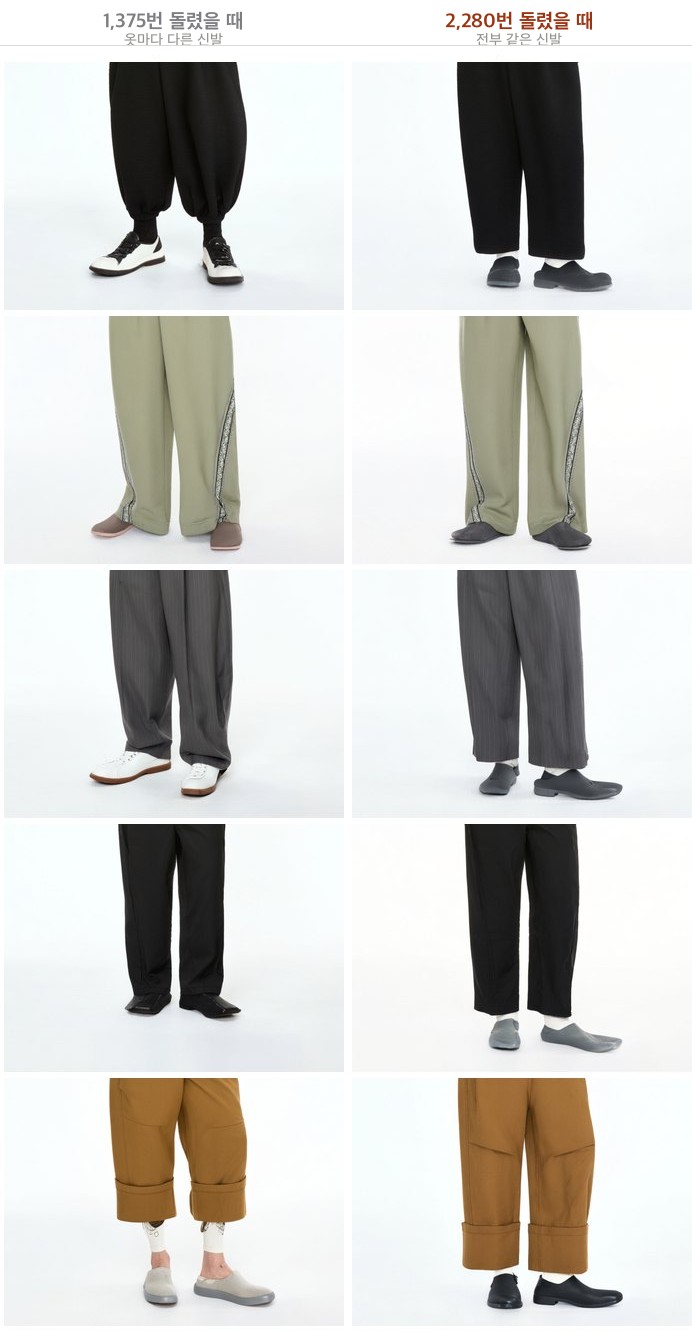
左は服ごとに違う靴が出てきました。白いスニーカー、ローファー、先のとがった靴、スリッポンが混ざっています。右は服が違っても、すべて同じ形です。多く回すあいだに、靴が一種類に絞られました。
背景でも同じことが起こります。説明文は背景を「無地」としか書いていませんでした。何色かは書いていません。その空欄を、モデルは学習で見たグレーで埋めます。私たちが使っていた白い背景ではなく、ブランドのスタジオのグレーです。
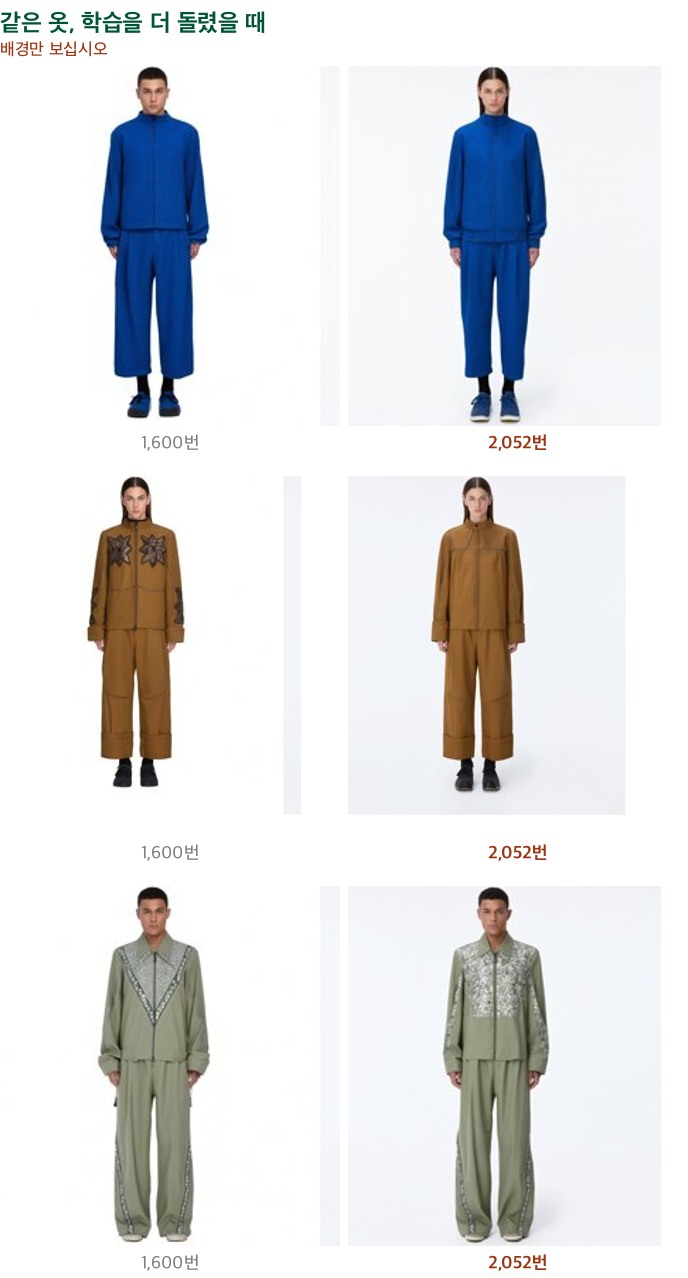
背景の明るさ(255 = 純白)
実際の着用カットの背景 255.0 途中の地点 254.8〜254.9 最終地点 248.5 ← 11本中7本が242〜246
2回とも、フィットより付随要素が先に崩れました。フィットは最後まで良くなり続けるので、フィットだけを見ているとこれに気づけません。フィットがいちばん良いときに、結果がいちばん良いとは限りません。
ですから、学習が終わった状態をそのまま使ってはいけません。途中の状態をいくつも残しておき、並べて選ぶ必要があります。これまで回した学習で、最後の状態がいちばん良かったことは一度もありません。そして、結果を見るときの確認項目に背景の明るさを加えました。目で見るだけでは見落としますが、数字なら捉えられます。
07 · What We Take
| 問い | 答え |
|---|---|
| ブランドのルックブックを学習すると、ルック&フィールをまねるか | まねます。色味・配色・スタイリングまで |
| 教えていないこともまねるか | まねます。入れていないトップスや靴を作って付けます |
| 学習になかった新作でもできるか | できます。検証した11本はすべて学習外の商品です |
| 適用の強さを上げると濃くなるか | なりません。その仮説は捨てました |
| 長く学習するほど良くなるか | なりません。ある地点から出力が固まります |
ブランドがこれまで撮ってきたルックブックの中に、そのブランドの服の着せ方が入っています。学習によって、それを引き出して使うことができます。
何を調整すべきかもわかりました。画像のサイズと、学習をどこで止めるかです。
次の問題は、その説明文を誰が書くかです。この学習に使った説明文も、人が書いたものではありません。Geminiが写真を見て文章を作り、付けました。
そして私たちは、同じことをサービスでも行っています。セラーが服の写真をアップロードすると、Geminiが商品説明を書きます。そして、セラーがそれを直します。その修正の記録が1万5千件以上たまっています。
Geminiが何を見誤るのか、人が何を直すのかが、そこにすべてあります。最終回ではその話をします。