StyleRoom は衣類の写真とモデルを受け取ってフィッティングショットを作り、それをリファレンスにして演出の入ったスタイルショットを作ります。この流れは今も問題なく回っています。
ただ、使っていると引っかかる箇所が二つありました。この記事は、その二つを一度に解く方法を見つけた記録です。
01 · Two Gaps
先にはっきりさせておきます。StyleRoom で後ろ姿のショットはすでに作れます。作業を始めるときに前で行くか後ろで行くかを先に選び、その選択がポーズや場所、フィッティングまで引き継がれます。衣類の後ろ側の写真を一緒にアップロードすれば、その背面も反映されます。
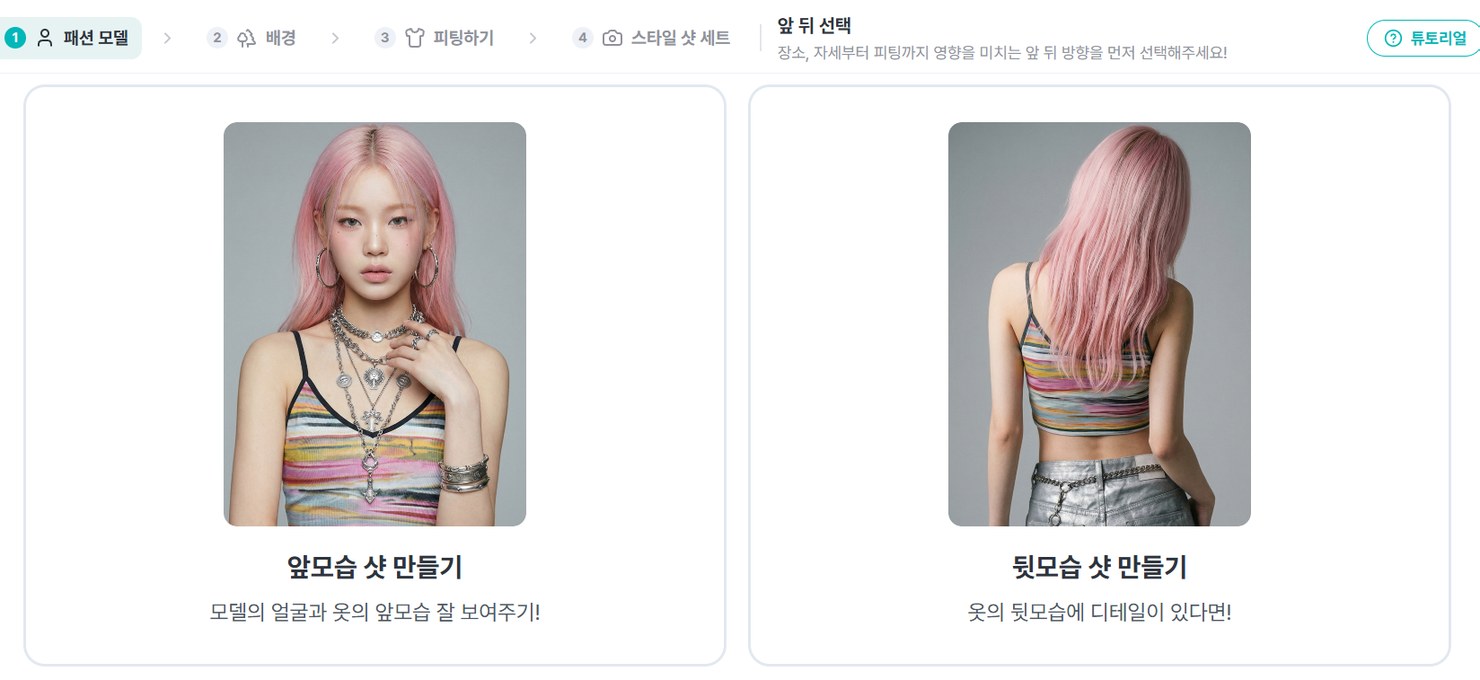
作業の最初のステップです。後ろ姿への道は最初からありました。
ところが、まさにここに一つ目の不足があります。前姿と後ろ姿をそれぞれ別に作らなければなりません。前姿のフィッティングショットを一回、後ろ姿をもう一回。作業が二回になるのも面倒ですが、より静かな問題は、その二つが別々の生成だという点です。Vol.10 で書いたとおり、同じ入力でも結果は揺れます。前後を別々に出せば、その揺れが二枚の間のズレとして現れます。同じ人物、同じ服だという保証が構造的にありません。
二つ目は顔です。全身一枚の中で顔が占める場所は思ったより小さく、モデルの印象が十分に出ないことがあります。下で数字をお見せします。
02 · One Sheet
一つ目の不足を解く鍵は、向きを変えることにありました。必要になるたびに一方向ずつ作るのではなく、最初に四方向を一度に確定しておくことです。
アニメーション制作にはキャラクター設定画というものがあります。一人のキャラクターを前から、横から、後ろから描いて一枚にまとめ、以降のすべてのカットがその一枚を見ます。そうして初めて、1話のキャラクターと12話のキャラクターが同じ人物になります。
同じことをフィッティングショットに持ち込みました。モデルと服が決まったら、まず前・横・横・後ろの四方向を一度の生成で作ります。すると二つが同時に片付きます。四カットは一度に出たので互いにズレようがなく、この一枚が前姿の作業にも後ろ姿の作業にもそのまま使われます。前面用と背面用を別々に作る理由がなくなります。
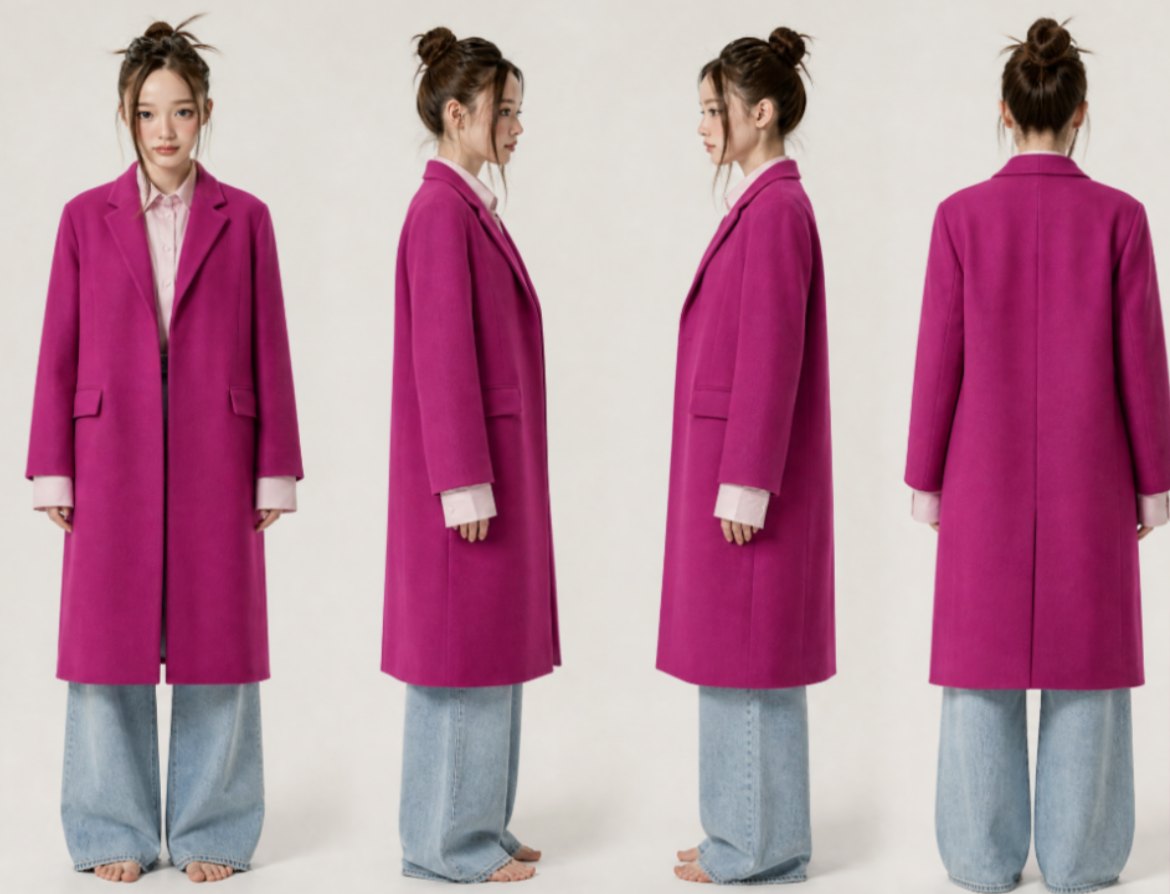
最初の試みです。四方向が一枚に収まり、四カットの服と人物も互いに一致しています。ここまでは成功です。ところが顔を見ると、二つ目の不足はむしろ悪化しています。
03 · Nine Percent
上の写真で顔を拡大するとぼやけています。計算してみれば当然の結果です。
一枚に全身四人を並べると、一人が横幅の四分の一を使います。人はおよそ七頭身から八頭身なので、頭は全身の高さの八分の一ほどです。実際に上の画像で生え際から顎までを測ると、顔の高さは画像全体の高さの約9%です。
そしてこれは解像度を上げて解ける問題ではありません。比率は解像度とは無関係だからです。2K で出そうが 4K で出そうが顔は依然として9%で、全体を二倍にすれば生成コストもその分上がります。
さらに顔は譲れる領域ではありません。「この結果はあのモデルで合っているか」を判定する根拠は、ほぼすべて顔にあります。服のしわが少し違うのは見逃せても、顔が違えばその写真は捨てます。最も重要な領域に、最も少ないピクセルが回っていました。
問題は解像度ではなく配置でした。
04 · A Canvas of Its Own
そこで全身と顔を分けました。全身四カットは頭なしで服だけを見せ、顔は別のシートとして分けて作ります。正面の顔を大きく、その下に横・横・後ろを小さく。このシートに服は出てきません。二枚をつなげたものが最終的なキャラクターシートです。
服を見せることがすべてです。
その下に横・横・後ろを小さく。
服は出てきません。
一枚にまとまったリファレンス。
顔に回るピクセルが変わります。専用のキャンバスでは正面の顔が画像の高さの約39%を占めます。9%から39%、長さで四倍を超え、ピクセル数では十七倍近くになります。全体の解像度はそのままです。
顔の高さ
顔の高さ
同じ解像度で
ここで一つ重要な点があります。「顔をもう少し大きく描いてほしい」と頼む方法もありました。試しましたが、あまり効きません。画像モデルは与えられたキャンバスの中で被写体の大きさを自分で決めます。言葉で頼むより、キャンバスを別に与えるほうがはるかに確実です。比率とキャンバスがそのまま構図の指示になります。
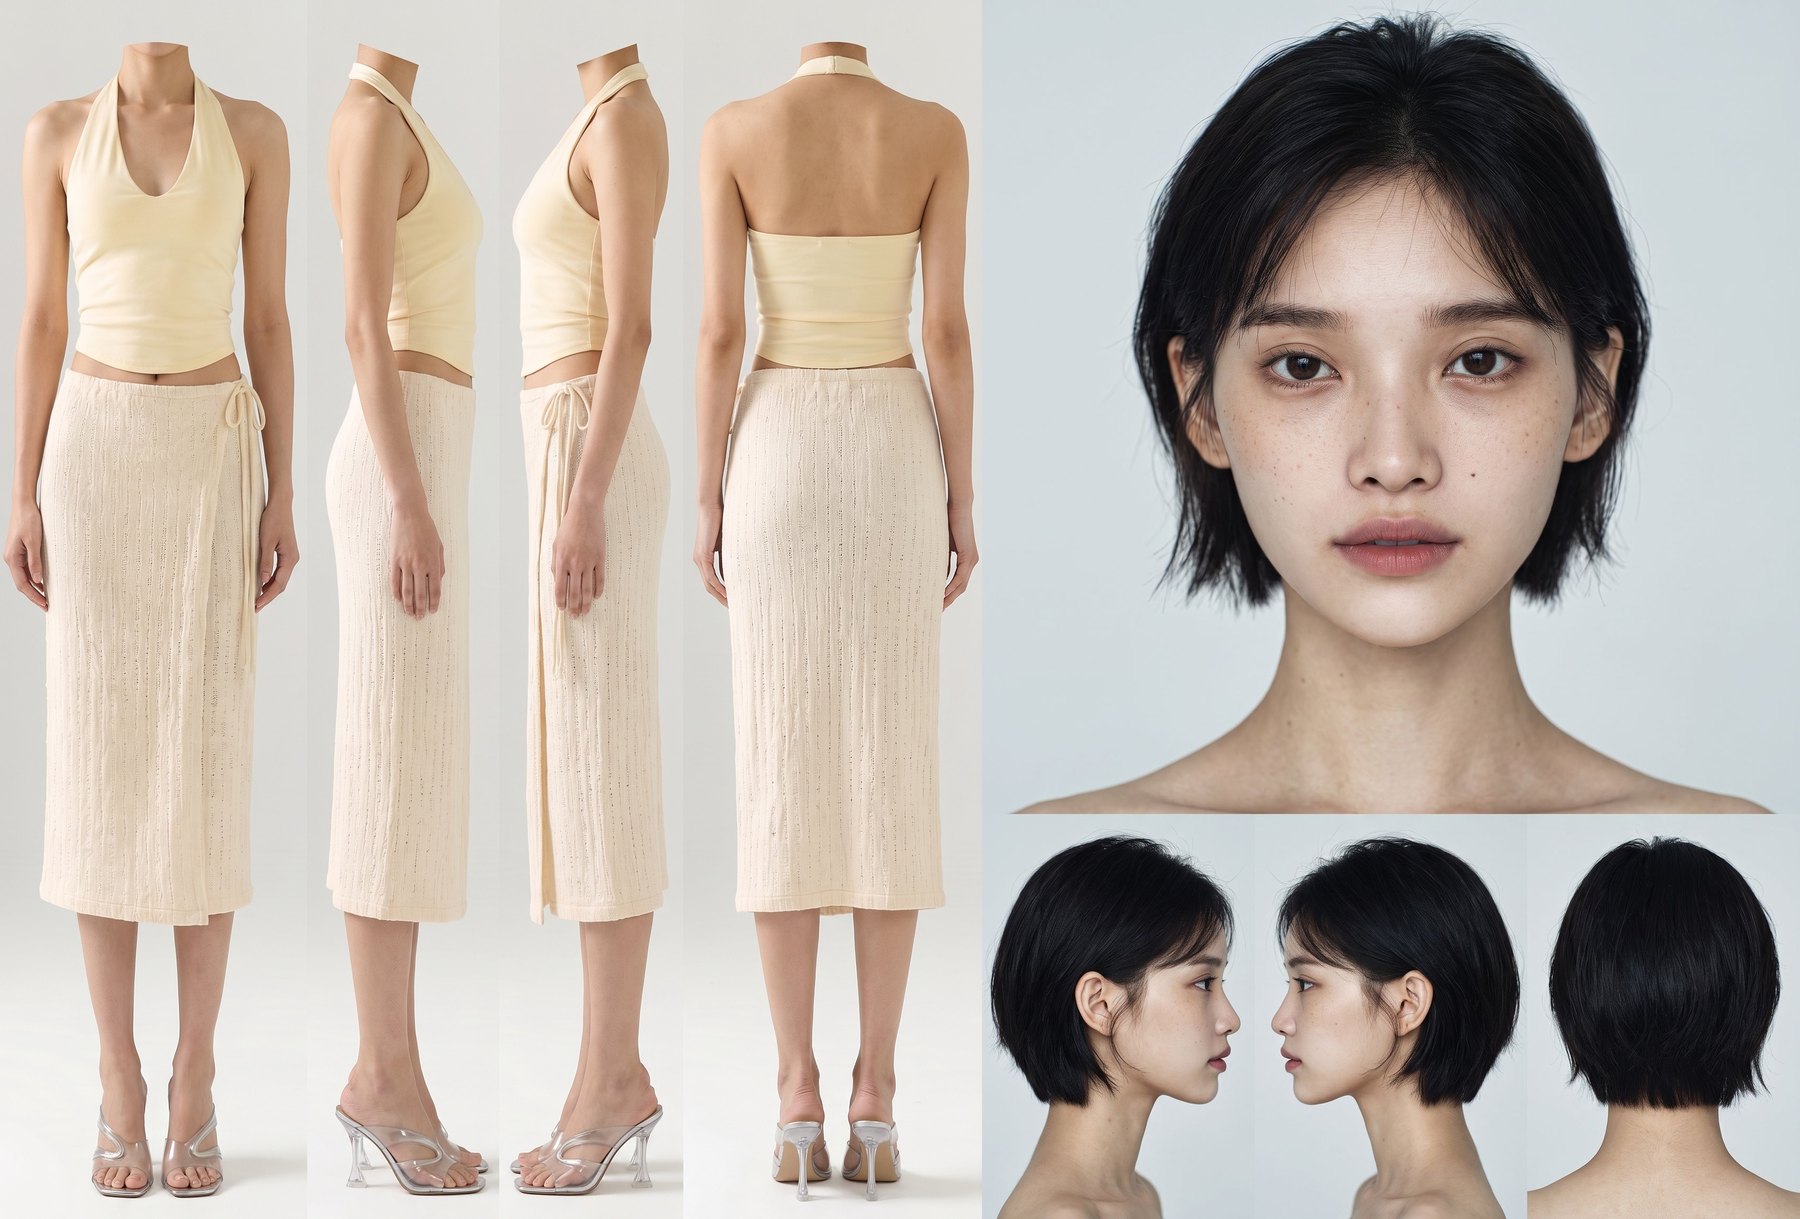
完成したキャラクターシートです。左の四カットには頭がなく、右に顔の四方向が付きます。この一枚で前姿の作業と後ろ姿の作業を両方まかないます。
05 · The Test
設計はもっともらしくても、一度に作った後ろ姿のカットが実際に使えるかは回してみないと分かりません。背面が厄介な服を一着選んでテストしました。
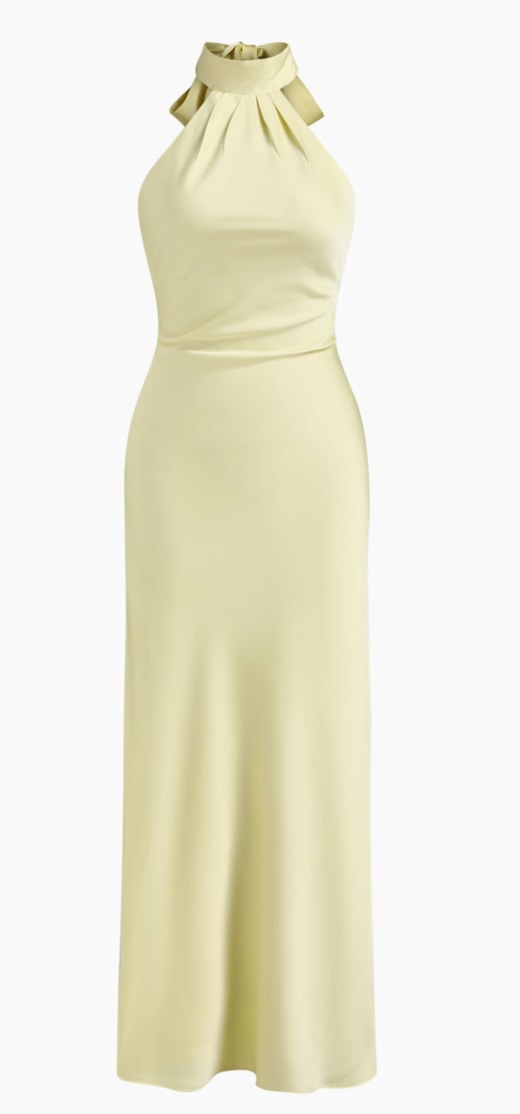
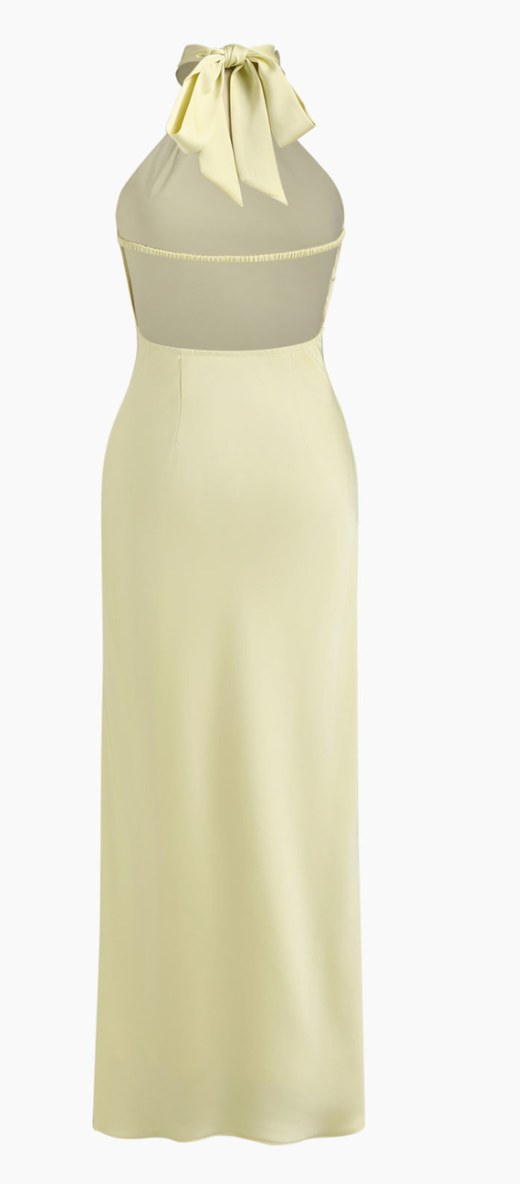
淡い黄色のホルターネックのロングドレスです。前から見ると装飾のない普通のノースリーブのドレスです。ところが後ろを向くと、うなじに大きなリボンが結ばれ、背中が完全に開いていて、その間を横向きのバンドが通ります。前面の写真だけではどれも分かりません。
まず基準線を一つ引きました。前面の写真だけをアップロードし、従来の方式で後ろ姿のフィッティングショットを依頼します。リファレンスに背面がないとどんな絵が出るのかを見るためです。
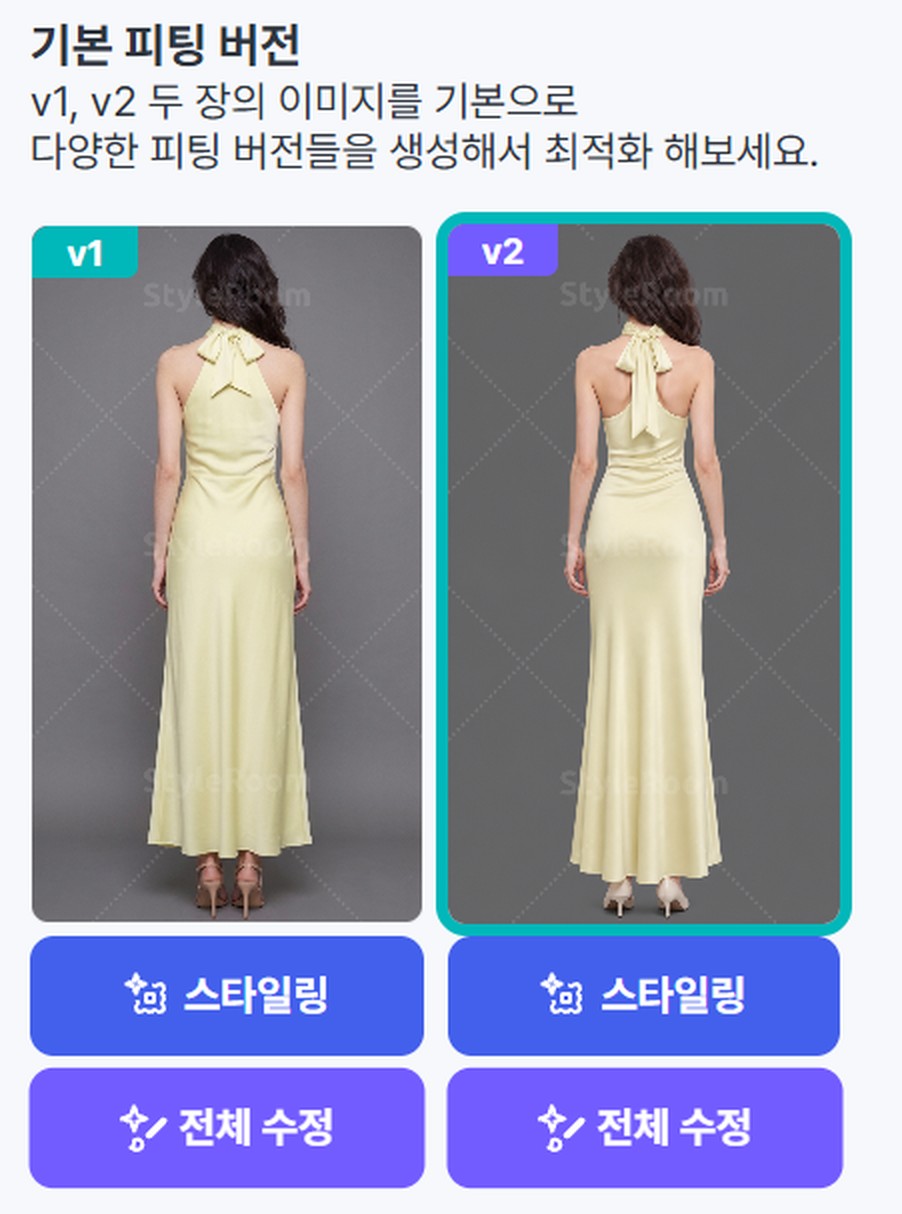
二枚とも背中が塞がったドレスに細いひもが垂れています。大きなリボンも、開いた背中も、横向きのバンドもありません。注目すべきは二枚が同じように間違っている点です。運が悪かったのではなく、リファレンスにないものはどちらを引いても当たりようがありません。
誤解を防ぐために書いておきます。キャラクターシートも背面の写真がなければ同じように想像します。リファレンスにないディテールを作り出す技術ではありません。キャラクターシートが変えるのは一度に、互いにズレず、顔まで大きくです。上の写真は、背面の情報が結果をどれだけ分けるかを示すための基準線です。
今度はキャラクターシートで作ります。前面と背面の写真を両方与え、四方向を一度に生成します。
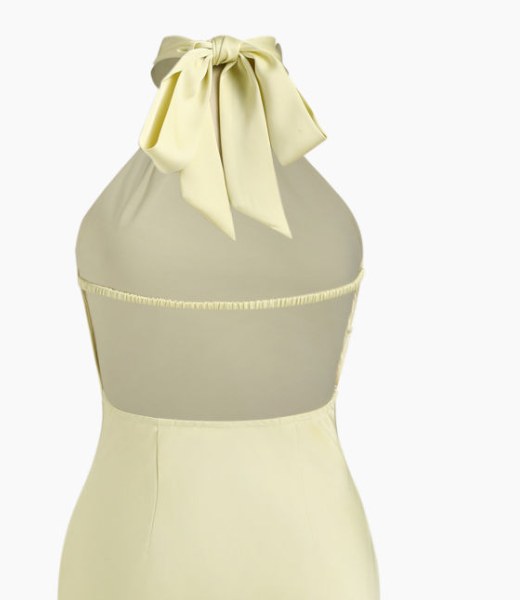
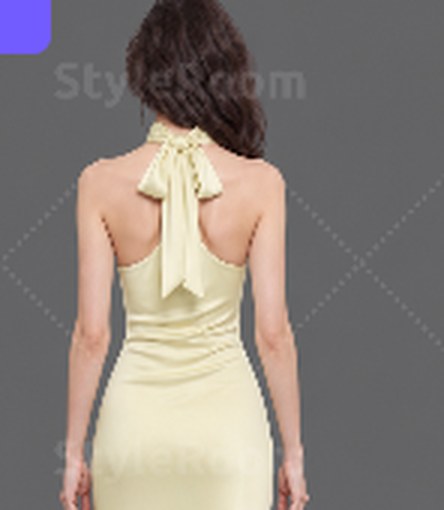
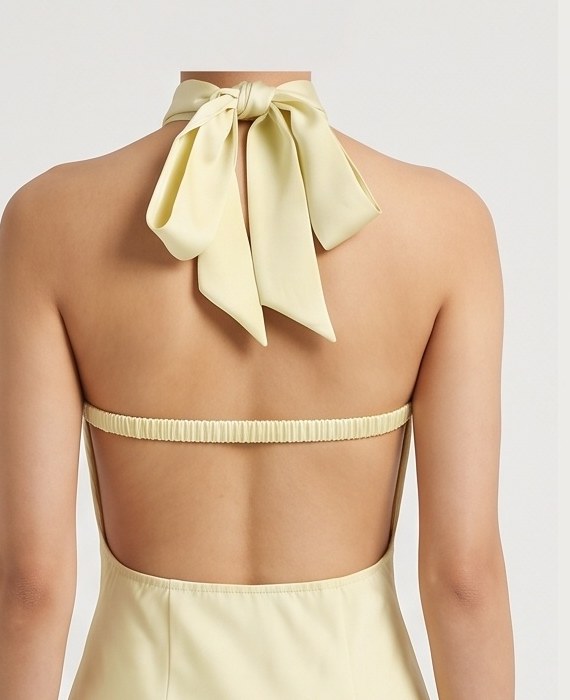
同じ箇所を並べて見ると違いは明らかです。中央はリボンの代わりに細いひもが垂れ、背中が塞がっています。右はリボンの結び目と垂れた端、開いた背中、横向きのバンドまで左と同じです。
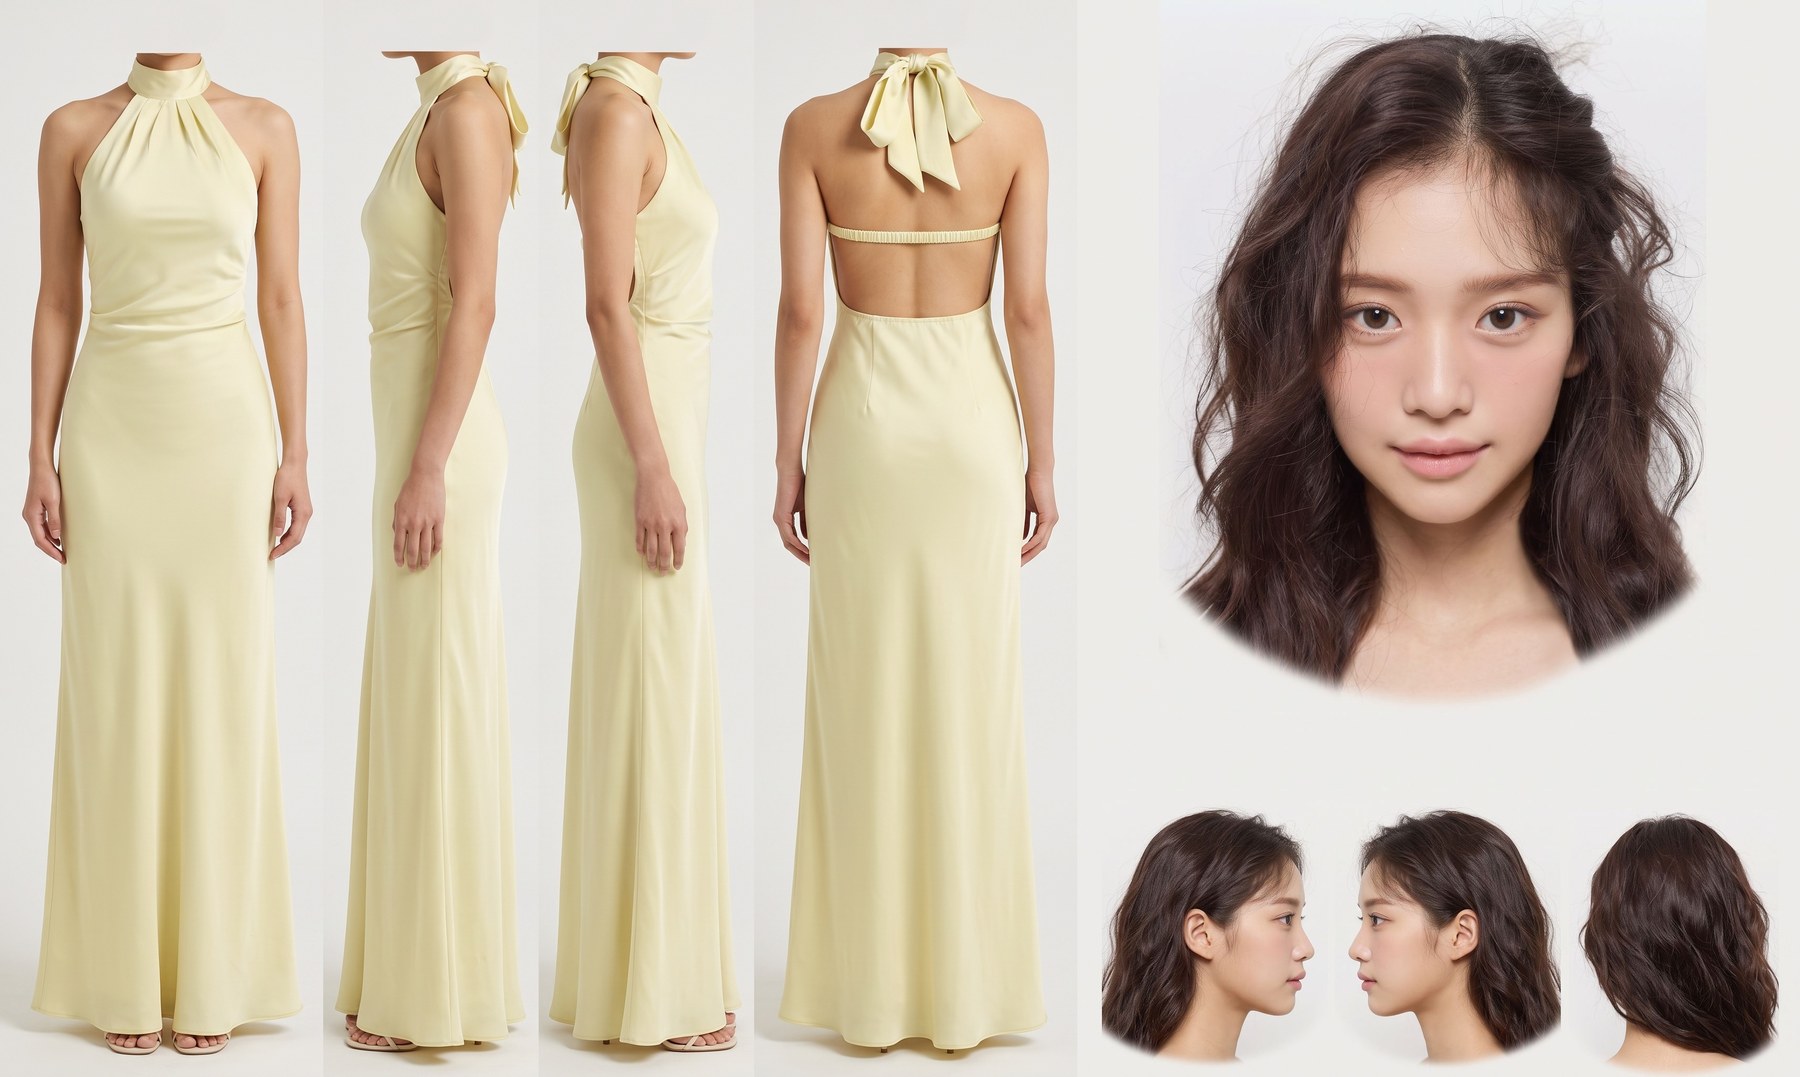
同じテストのキャラクターシート全体です。四カットが一度の生成から出たため、横向きの二カットでもリボンの端が肩越しの同じ位置に掛かっています。前後を別々に出したら合わせにくい部分です。
06 · Coming Soon
最初に挙げた二つに戻ります。
キャラクターシートはまもなく StyleRoom に入ります。モデルと服を選べば四方向と顔が収まった一枚がまず作られ、その後の演出写真はすべてこの一枚を見て作られます。前姿を使っても後ろ姿を使っても、同じ人物、同じ服です。