このシリーズの Vol.03 は、この一文から始まりました。汎用画像モデルはバルーンフィットをレギュラーフィットに、ワイドパンツをストレートに描き替えてしまいます。学習データの平均へ回帰するのです。
最初はプロンプトの問題だと考えました。より長く、より具体的に、より強く指示してみました。結果は同じでした。当然です。モデルが知らないシルエットは、どれだけ正確に要求しても描かれません。言語で知識を注入することはできません。知識は学習からしか入りません。
そこであの記事では、こう整理しました。言葉はすでにあるものを呼び出すだけで、ないものを作りはしない。知らないものは見せるしかない。そして、あるブランド一社のシルエットをLoRAで教える実験(Vol.05)まで行きました。
今回はその続きです。実験を運用規模に引き上げること。ブランド一社ではなく、私たちが取り扱うすべての品目を教える作業です。その過程は4つの分かれ道でした。
01 · The Fork
最初の分かれ道は規模でした。ゼロから自社モデルを作るのか、すでに強力なオープンモデルの上に自社の知識だけを載せるのか。LoRA(Low-Rank Adaptation)は後者です。ベースモデルの数百億パラメータはそのままにして、その傍らに小さなアダプターを付け、特定の知識だけを学習させる方式です。元の本には手を触れず、薄いメモを挟み込むのに近い。メモは軽く、何枚でも作れて、いつでも外せます。
| ファンデーションモデル構築 | LoRA | |
|---|---|---|
| 費用 · 期間 | 数百万ドル、数か月 | GPU数日 |
| 必要データ量 | 数億枚 | カテゴリあたり数百ペア |
| 更新サイクル | 再学習そのものが一つのプロジェクト | 四半期単位の更新が可能 |
| ベース進化の恩恵 | 受けられない。自分のモデルは自分でしか育たない | より良いオープンベースが出れば乗り換えられる |
| 失敗のコスト | プロジェクト全体 | LoRA一つ |
表だけ見れば当然の選択に見えますが、決め手は費用ではなくサイクルでした。ファッションのトレンドは季節単位で変わります。汎用モデルが新しい流行を反映するには次のバージョンを待つしかなく、その間に半年から1年が過ぎます。ファンデーションモデルを自前で作っても事情は同じです。「重く一度」学習するものは季節のサイクルに追いつけません。LoRAは「軽く頻繁に」を可能にします。流行を売る事業には、後者が構造的に合った道具です。
もちろん限界も明確です。LoRAはベースモデルが知らないものを無から作り出すことはできません。この方式を選べたのは、目標が「新しい能力の創造」ではなく「すでに描けている服のシルエットとディテールを矯正すること」という狭い課題だったからです。道具が良かったのではなく、課題と道具が合っていました。
02 · The Base
LoRAを載せるベースは二つの候補に絞りました。Qwen-Image-Edit 2511(20B)とFLUX.2 Klein 9B。どちらもApache 2.0ライセンスで商用上の制約が同じだったため、選定基準は純粋に品質一つに整理されました。
同じ学習データ、同じレシピ、同じ評価セットで二つのモデルを並べて回しました。結果は一貫してQwenの優位でした。とくに衣類において致命的な領域であるプリント、文字、編み目といった微細ディテールの再現で差が出ました。Qwen-Image系がそもそもテキストレンダリングに特化して設計されたモデルであることを考えれば、事後的に納得できる結果でした。
この比較戦で得た副産物がもう一つあります。データと評価体系を特定のモデルに縛らず中立に設計しておけば、より良いベースが登場したときに比較戦をやり直すコストがほとんどかかりません。ベースは変わるという前提で設計すること。オープンモデルの生態系で学習を運用する基本だと考えています。
03 · Sixty-One
次の分かれ道。「衣類全体」を教えるLoRAを一つ大きく作るのか、品目ごとに細かく分けるのか。私たちは性別 × 小分類で分けて61個を学習させる方を選びました。
理由は単純です。ニットが学ぶべきシルエットとスラックスが学ぶべきシルエットは別の知識です。ニットで重要なのは編み地の質感と体に沿って落ちる仕方であり、パンツで重要なのは股上とワタリ、そして裾が靴の上で折れる仕方です。これを一つのアダプターに詰め込めば、互いを平均して薄めてしまいます。直そうとしたまさにその問題を、アダプターの中で再現することになります。
Vol.03とVol.05のブランドLoRAとは軸が違います。ブランドLoRAが「このブランドの感度」を学ぶ縦軸だとすれば、小分類LoRAは「この品目の構造」を学ぶ横軸です。運用面でもこの構造が有利です。生成時にはリクエストされたモデルの性別と衣類の小分類に合うLoRAを一つだけ選んで差し込めばよく、流行が変われば変わった品目のLoRAだけを学習し直せば済みます。最初の分かれ道で述べた「軽く頻繁に」が、ここで完成します。
大分類(アウター · トップス · ボトムス)の下の小分類ごとに、メンズ · ウィメンズをそれぞれ学習させました。生成時にはこのうちちょうど一つが選ばれ、ベースモデルに重なります。
04 · Pairs
学習データはスタイルルームが自社撮影した写真を使用しました。ここで重要なのは枚数ではなく構造です。私たちはバラバラの写真の山ではなく、商品カットと着用カットのペアとしてデータを設計しました。服が掛かっているときの姿と人が着たときの姿をペアにして見せて初めて、モデルは「この服が体の上でどう落ちるか」という関係そのものを学びます。
学習ペアとキャプション。キャプション冒頭のトークン(例)が、この知識を小分類に結びつける鍵です。生成時に同じトークンを呼べば、その小分類の学習済みシルエットが呼び出されます。
キャプションには小分類ごとに固有のトリガートークンを埋め込みました。学習した知識に名札を付けておくということです。この名札のおかげで、推論時に「ニットセーターのシルエット知識」だけを正確に呼び出せ、61個のLoRAが互いに干渉しません。
05 · The Metal
学習も生成も、すべてNVIDIA H100 80GB 1枚のVMで回しました。「1枚」が核心です。20Bモデルをbf16で載せると約56GB。そこにLoRAアダプターと作業バッファを足しても80GB 1枚に収まります。私たちの規模では、大きなGPU 1枚のほうが小さなGPU複数枚より優れています。モデルを分割して載せるマルチGPU分散は、それ自体が運用すべき複雑さだからです。
GPUはGoogle Cloudで借りています。理由は単純です。学習データとチェックポイントがすでにGCSにあります。数十万枚のデータをGPUのある場所へ動かすより、データのある場所へGPUを呼ぶほうが安く速い。VMは常時保有しません。仕事が発生したら立ち上げ、一定時間アイドルなら自動で削除されます。GPUは所有するものではなく、借りる時間です。
ただしこの方式には現実的な制約が一つあります。H100は望むゾーンに常に在庫がある品物ではありません。ある日はシンガポールで、ある日は米国中部で、ある日は欧州で確保できます。そのためVMは最初から「どのリージョンで起動してもスクリプトを取得して同じ状態で立ち上がる」形に作ってあります。在庫を探してゾーンを渡り歩くことが運用の一部です。
学習フレームワークは、Qwen-Imageを公式サポートするオープンソースのDiffSynth-Studioを使用しました。
生成側の核心技術はLoRAホットスワップです。LoRAを使う一般的な方式はアダプターをベースモデルに統合(fuse)してしまうことですが、私たちのようにアダプターが61個ある場合、この方式は成り立ちません。統合版61着は20Bモデル61着と同じです。代わりに、ベースモデル1着をGPUメモリに常駐させておき、リクエストが来るたびに該当する小分類のアダプターだけを差し替えます。統合は元に戻せませんが、ホットスワップはリクエスト単位で乗り換えられます。GPU 1枚が61の小分類をすべてサービスする構造は、こうして作られます。
この構造で必ず確認すべきことが一つあります。アダプターを外したとき、ベースモデルは本当に元どおりに戻るのか。私たちはアダプターを付けて外した後のベース出力が最初とビット単位で同一であることを確認してから、この構造を採用しました。アダプターの差し替えがベースを汚染するなら、61個が互いの結果を染め合う災厄になります。
| GPU | NVIDIA H100 80GB × 1(学習 · 生成とも同一) |
| クラウド | Google Cloud。データ(GCS)のある場所へGPUを呼ぶ。アイドル時に自動削除 |
| 学習 | DiffSynth-Studio · rank 32 · 12エポック · エポックごとにチェックポイント |
| 生成 | bf16常駐ベース(約56GB)+ LoRAホットスワップ · 40ステップ · 縦1792px |
| 比較実験 | シード固定。ベースとLoRA適用版の差だけを残す |
06 · The Recipe
レシピ自体は淡白です。rank 32、12エポック。私たちが力を入れたのは値ではなく構造です。各エポックが終わるたびにチェックポイントを保存し、学習が終わった後に12の時点から選べるようにしました。
こうする理由は、LoRA学習の失敗の大半が過学習だからです。教えすぎるとモデルは服のシルエットではなく学習写真そのものを覚え始めます。ところが「どれだけ教えれば適切か」は小分類ごとに異なり、回してみるまで分かりません。そこで私たちは学習を巻き戻せる形に設計しました。最適点を過ぎたと後から気づいても、その手前のチェックポイントに戻ればよいのです。
07 · Three Traps
ここまでが設計だとすれば、以下は実際にぶつかったものです。61個を学習させる間、私たちを最も悩ませたのは三つでした。
ベースモデルがメンズ衣類のリクエストに女性モデルを描いてしまうことは珍しくありませんでした。考えてみれば当然です。服の写真1枚には「この服を誰が着るか」という情報がなく、モデルは学習データでより多く見たほうへ傾くだけです。プロンプトで性別を指示しても、服の見た目が反対方向へ引けば負けます。そこで私たちは小分類を性別でもう一度分割し、メンズのニットとウィメンズのニットをまったく別のLoRAとして学習させました。61という数字の半分は、実はこの決定から来ています。
学習写真には服だけが写っているわけではありません。構図、照明、背景のムードまで一緒に写っていて、LoRAはそれを丸ごと学びます。Vol.05で「説明文に書かなかったものを学びます」と書いた、あの現象です。放置すると特定の小分類が上半身のクローズアップばかり吐き始めます。学習写真の構図がそうだったからです。
解法はキャプションの分離原則です。キャプションに書いた特徴は指示で制御できる変数として分離され、書かなかった特徴はトリガートークンに焼き付きます。だからキャプションには服の特徴だけでなく構図まで明記します。「worn by the person, upper body」のような記述を付けておけば、構図はキャプション側へ分離され、トークンが呼び出す知識が服に集中します。
レシピで述べたチェックポイント戦略は、保険ではなく必須でした。学習を最後まで回してみると、実際に投入に値するチェックポイントはほぼ常に最終エポックより手前で出ました。最後まで行ったモデルは服のシルエットではなく学習写真そのものを覚え始めます。Vol.05の結論と同じです。フィットが最も良いときに結果物が最も良いわけではありません。問題はその最適点がどこかを回してみるまで分からないことで、だからこそ「エポックごとに保存」は学習が始まる前に設計されていなければなりません。学習が終わった後に立てる計画は役に立ちません。
08 · Result
小分類LoRA
中央値(255スケール)
衣類の着数
61の小分類すべてが学習を完走しました。効果は内部検証セットで測りました。同じ服、同じシードでベースモデルとLoRA適用版を並べて生成し比較する方式です。衣類27着基準で、二つの結果の画素平均差は255スケールで中央値37を超えました。微調整ではなく、別の絵が出るということです。
変わる方向は三つに要約されます。シルエット(ワタリ · 丈 · ネックラインが商品側へ移動)、編み地とディテール(編み目 · プラケット · プリントが復活)、そしてモデル整合(性別 · 体型がリクエストどおりに固定)です。検証で出会った場面を二つ。
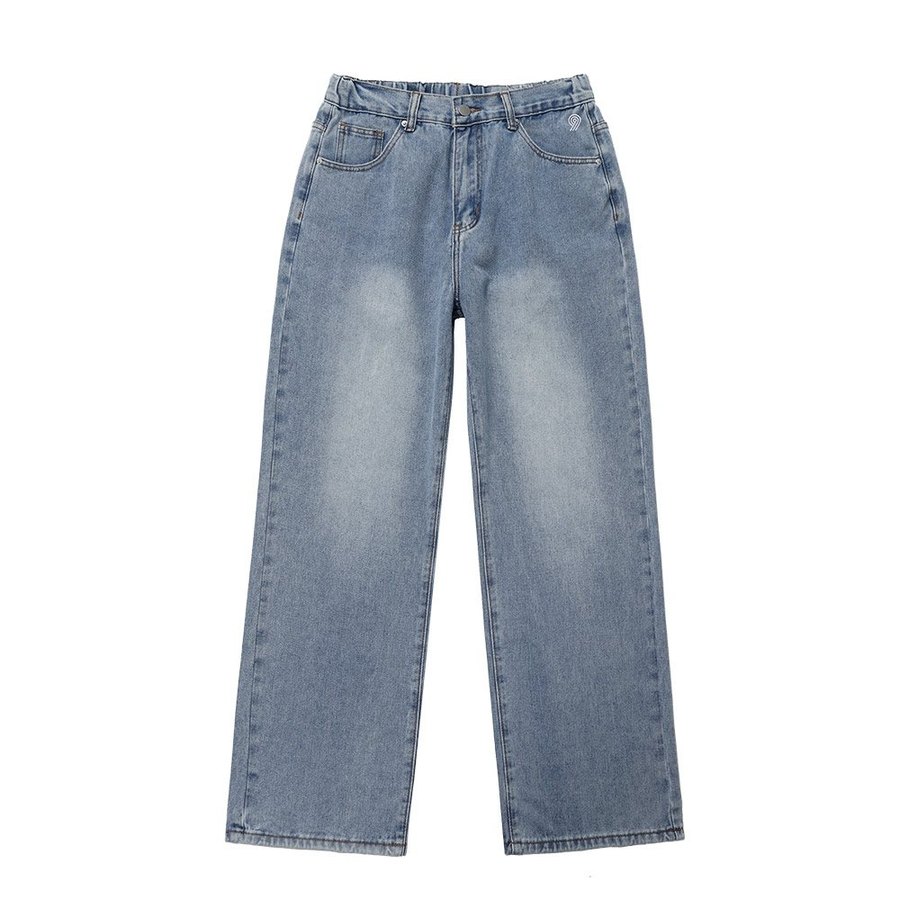
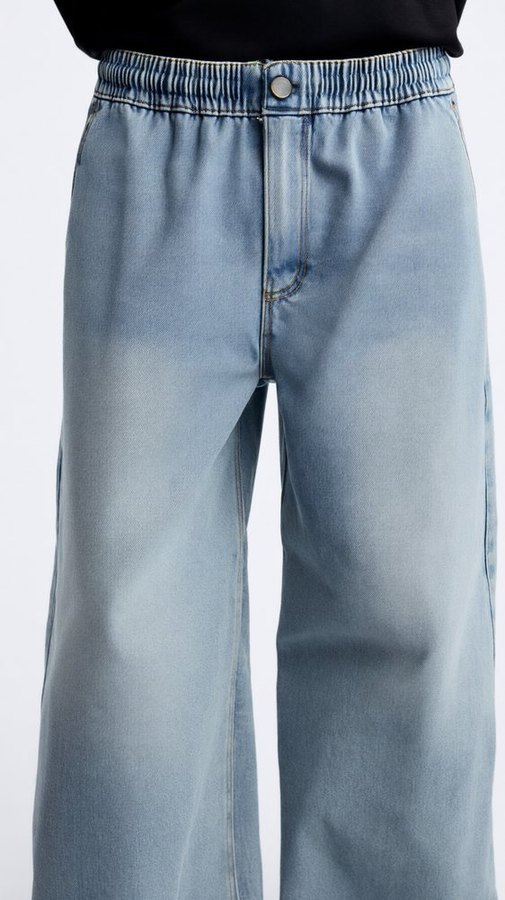
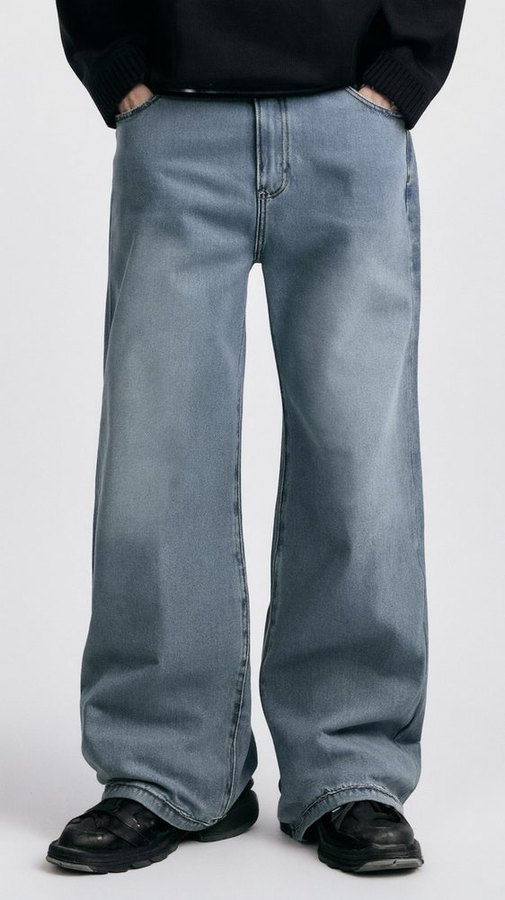
フラットウエストのワイドデニム。ベースモデルはウエストをゴムバンドに描き替え、LoRA適用版はウエストとワタリを商品どおりに戻しました。
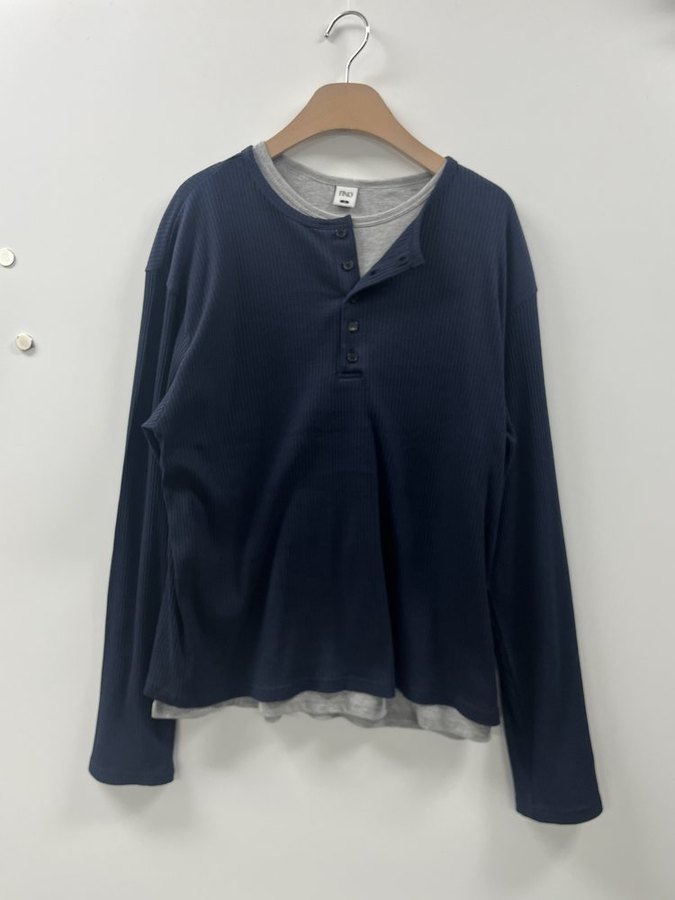
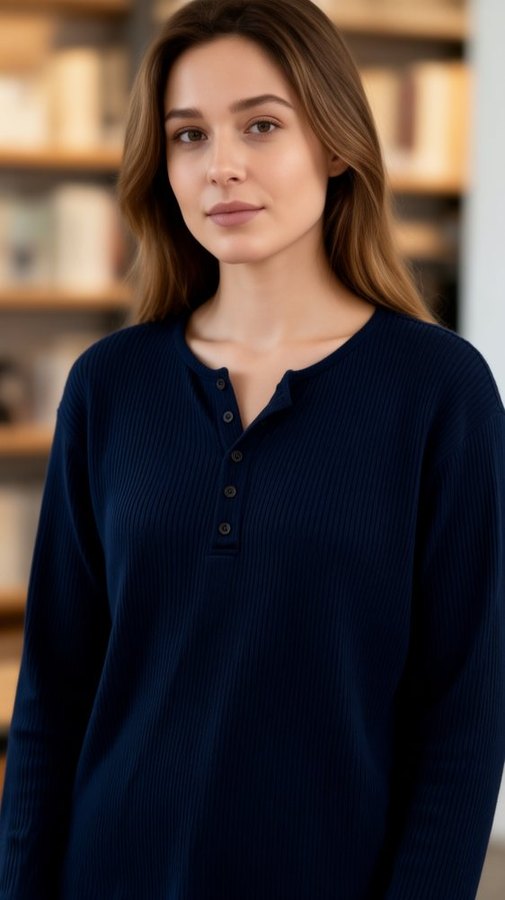
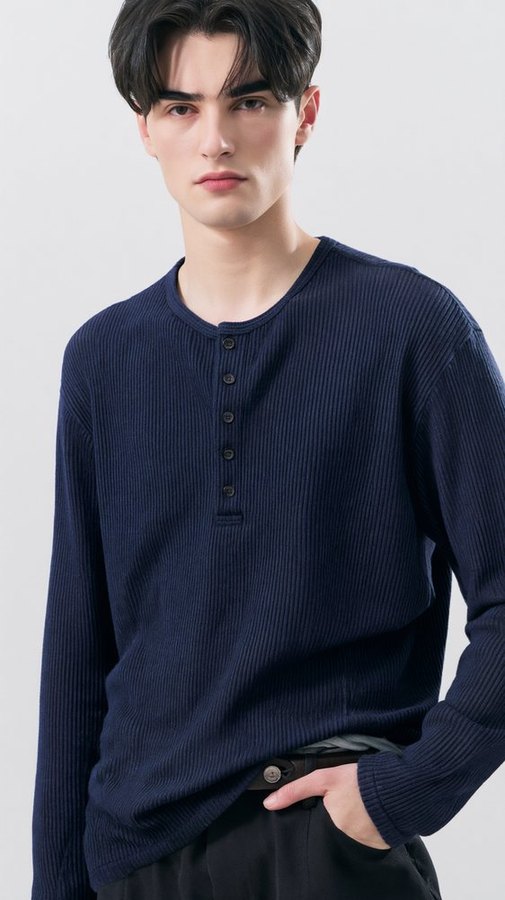
落とし穴1と結果が1枚に収まった例です。ベースモデルはメンズ衣類を女性モデルに着せ、ディテールまで潰しました。小分類LoRA一つが二つの問題を同時に捕まえます。
正直に付け加えると、すべての品目が同じ幅で良くなったわけではありません。編み地とディテールの多い品目(ニット、シャツ類)ほど改善幅が大きく、形が単純なベーシック品目はベースモデルもすでにそれなりに描けていました。LoRAはベースが知らない分だけ働きます。だからこそ小分類ごとに分けた構造が再び効いてきます。うまくいかない品目にだけ力を足せるからです。
09 · The System
整理すると4つの決定でした。
- ファンデーションではなくLoRA。トレンドのサイクルに追いつけるほう
- 同条件の比較戦でベースを選定。ライセンスが同じなので品質だけで
- 一つではなく小分類61個。シルエットは品目ごとに別の知識だから
- バラバラではなくペア。服と着用の関係そのものを教えるデータ構造
4つの決定は一つの方向を指しています。私たちは「完成したモデル」を作ろうとしたのではありません。流行が変わるたびに、変わった部分だけを教え直せる仕組みを作ろうとしたのであり、その仕組みは今も回っています。次のシーズンのシルエットが現れれば、61個のうち該当する品目のLoRAが静かに入れ替わるでしょう。
Vol.03をこう締めくくりました。モデルは借りて使うが、その上に残るものは私たちのものだ、と。いまその一文に数字が付きました。六十一個。