スタイルルームを使っていると気づくことが一つあります。フィッティングショットが必ず2枚ずつ出てくることです。ユーザーはそのうち気に入った1枚を選んで使います。表向きは単なる便利機能に見えます。
実はこのシリーズで最も念入りに設計した仕掛けの一つです。この記事は「2枚」という数字に込められた設計の話です。
01 · No Answer Key
生成された画像に正解はありません。数学の問題なら答えが合っているか採点できますが、フィッティングショットには「これが100点の写真だ」という基準紙が存在しません。
だから生成AIを運用する企業の本当の難題は、生成ではなく判定です。どちらの写真が良いのか。この判定を自動化しようとする指標はありますが、指標はしばしば騙されます。鮮明な写真は良い写真と同じ言葉ではなく、原本に似た写真は売れる写真と同じ言葉ではありません。
人に聞けばよいのでしょうか。私たちはコリアEコマースフェアで1,865回の実測(Vol.08)から一つ学びました。人々はAIカットと実際のルックブックを55.8%しか見分けられません。本物と偽物を分けることすらこれほど難しいのに、「どちらがより良いか」は好みまで混じる、さらに難しい問いです。人を雇って点数をつけさせるラベリングは高く、遅く、ラベラーごとに物差しが違います。
02 · Already Happening
ところが自社の製品の中を覗いてみると、この難しい判定がすでに毎日起きています。
スタイルルームはフィッティングのリクエスト1件ごとに写真を2枚作ります。同じモデル、同じ服、同じ条件。違うのは生成の偶然だけです。そしてユーザーは二つのうち気に入った1枚を選んで使います。
ユーザーにとってこれは単に選ぶ行為です。しかしデータの目で見れば、これは完璧に統制されたブラインドA/B判定です。同じ入力から出た二つの結果を、その写真を実際に商売に使う当事者が、何の対価もなく、真剣に比べてくれたのです。アンケートでお願いしていれば適当に押されたであろう判定を、自分の売上がかかっているセラーは本気で下します。
同じ条件
生成の偶然だけ
実際に使用
を記録
選好データが積み上がる経路。どの段階にも「ラベリング」という別作業がありません。製品が回ること自体がデータ生産です。
03 · The Pair
こうして積み上がるデータの形はこうです。(同じ入力、選ばれた写真、落ちた写真)。私たちはこれを選好ペア(preference pair)と呼んでいます。
選好ペアが強力なのは、物差しが要らないからです。「この写真は何点ですか」という問いは人ごとに物差しが違って答えが揺れます。しかし「同じ条件のこの二つのうちどちらですか」という問いに物差しは要りません。モデルにとっても同じです。絶対点数より同じ条件での相対比較のほうが、はるかに鮮明な学習信号です。近年の生成モデルのアラインメント手法が揃ってこの形のデータの上に立っているのは偶然ではありません。
このデータが今数万ペア積み上がっています。作るのに使ったラベリング予算は0円です。
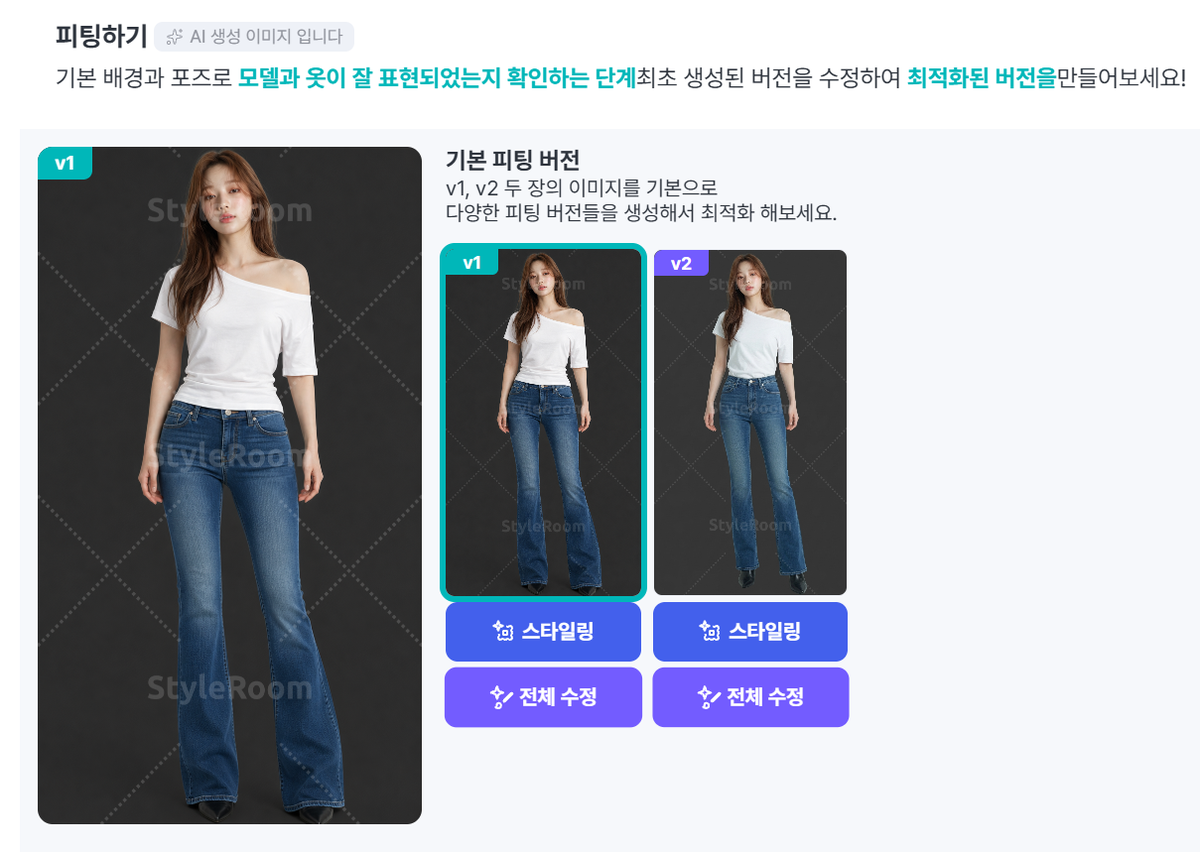
実際のフィッティング画面です。同じモデル、同じ服から作られたv1とv2が並び、ユーザーはどちらかを選んでスタイリングや修正へ進みます。その瞬間に保存されるのが上の一行です。何が良かったかではなく、何が何に勝ったかを記録します。それで十分です。
04 · By Design
「運よくデータが積み上がりましたね」と読まれないように、はっきりさせておきます。このデータは拾ったものではなく、製品をそう作ったから出てきたものです。三つが揃う必要があります。
- 2枚は同じ入力 · 同じ条件から出なければなりません。片方は今日の版で、片方は先週の版で作れば、その選択は判定として使えません。比較対象が統制されていない選択はノイズです。
- 選ぶ行為がユーザーにとって自然な次の一歩でなければなりません。「データのために評価してください」とお願いした瞬間、回答率と真剣さが崩れます。選択がユーザー自身に必要な作業であってこそ、判定は本気になります。
- 2枚でなければなりません。1枚だけ作れば判定そのものがありません。4枚作れば選ぶことが労働になり、生成コストは倍になります。2枚はユーザーにとって「選べる最小限の自由」であり、私たちにとって「判定が成立する最小限の構造」です。
05 · Handle With Care
正直に書いておくと、選好ペアは万能ではありません。選択は「この写真が良い」ではなく、「二つのうちこちらがましだ」でしかありません。両方とも物足りなくても、どちらかは選ばれます。好みと品質が混じって入ってきますし、何も選ばなかったユーザーの気持ちは記録に残りません。
だから私たちはこのデータを正解表ではなく羅針盤として使います。ペア一つひとつは揺れますが、数万件が集まれば方向が見えてきます。ユーザーはどんな失敗を許さないのか、どんな違いには無頓着なのか。その方向が、次の学習が力を注ぐべき場所を教えてくれます。
06 · Where It Goes
Vol.09では、モデルに「何を描くか」を教える話をしました。小分類LoRA 61個です。選好ペアはその次の段階の材料です。「どちらがより良いか」を教えるアラインメント学習に入ります。その学習が終わったら、結果を持ってまた伺います。
この記事の要旨を一段落に縮めるとこうです。データの堀は集めるものではなく設計するものです。生成はモデルがします。判定はユーザーがします。そしてその判定が次のモデルを作ります。