스타일룸을 쓰다 보면 눈치채는 것이 하나 있습니다. 피팅샷이 항상 두 장씩 나온다는 점입니다. 사용자는 그중 마음에 드는 한 장을 골라 씁니다. 겉으로는 단순한 편의 기능처럼 보입니다.
사실은 이 시리즈에서 가장 공들여 설계한 장치 중 하나입니다. 이 글은 "두 장"이라는 숫자에 담긴 설계 이야기입니다.
01 · No Answer Key
생성된 이미지에는 정답이 없습니다. 수학 문제라면 답을 맞혔는지 채점할 수 있지만, 피팅샷에는 "이것이 100점짜리 사진"이라는 기준지가 존재하지 않습니다.
그래서 생성 AI를 운영하는 회사들의 진짜 난제는 생성이 아니라 판정입니다. 어느 사진이 더 좋은가. 이 판정을 자동화하려는 지표들이 있지만, 지표는 곧잘 속습니다. 선명한 사진이 좋은 사진과 같은 말이 아니고, 원본과 닮은 사진이 팔리는 사진과 같은 말이 아닙니다.
사람에게 물으면 될까요. 우리는 코리아 이커머스 페어에서 1,865판의 실측(Vol.08)으로 한 가지를 배웠습니다. 사람들은 AI 컷과 실제 룩북을 55.8%밖에 가리지 못합니다. 진짜와 가짜를 가르는 것도 이렇게 어려운데, "무엇이 더 좋은가"는 취향까지 섞이는 더 어려운 질문입니다. 사람을 고용해 점수를 매기게 하는 라벨링은 비싸고, 느리고, 라벨러마다 저울이 다릅니다.
02 · Already Happening
그런데 우리 제품 안을 들여다보면, 이 어려운 판정이 이미 매일 일어나고 있습니다.
스타일룸은 피팅 요청 한 건마다 사진을 두 장 만듭니다. 같은 모델, 같은 옷, 같은 조건. 다른 것은 생성의 우연뿐입니다. 그리고 사용자는 둘 중 마음에 드는 한 장을 골라 씁니다.
사용자에게 이것은 그냥 고르는 행위입니다. 그러나 데이터의 눈으로 보면 이것은 완벽하게 통제된 블라인드 A/B 판정입니다. 같은 입력에서 나온 두 결과를, 그 사진을 실제로 장사에 쓸 당사자가, 아무 대가 없이, 진지하게 비교해 준 것입니다. 우리가 설문으로 부탁했다면 성의 없이 눌렀을 판정을, 자기 매출이 걸린 셀러는 진심으로 내립니다.
같은 조건
생성의 우연뿐
실제로 사용
기록
선호 데이터가 쌓이는 경로. 어느 단계에도 "라벨링"이라는 별도 작업이 없습니다. 제품이 돌아가는 것 자체가 데이터 생산입니다.
03 · The Pair
이렇게 쌓이는 데이터의 형태는 이렇습니다. (같은 입력, 선택된 사진, 탈락한 사진). 우리는 이것을 선호쌍(preference pair)이라고 부릅니다.
선호쌍이 강력한 이유는 저울이 필요 없기 때문입니다. "이 사진은 몇 점입니까"라는 질문은 사람마다 저울이 달라서 대답이 흔들립니다. 그러나 "같은 조건의 이 둘 중 어느 쪽입니까"라는 질문에는 저울이 필요 없습니다. 모델에게도 마찬가지입니다. 절대 점수보다 같은 조건의 상대 비교가 훨씬 선명한 학습 신호입니다. 최근의 생성 모델 정렬 기법들이 일제히 이 형태의 데이터 위에 서 있는 것은 우연이 아닙니다.
이 데이터가 지금 수만 쌍 쌓여 있습니다. 만드는 데 쓴 라벨링 예산은 0원입니다.
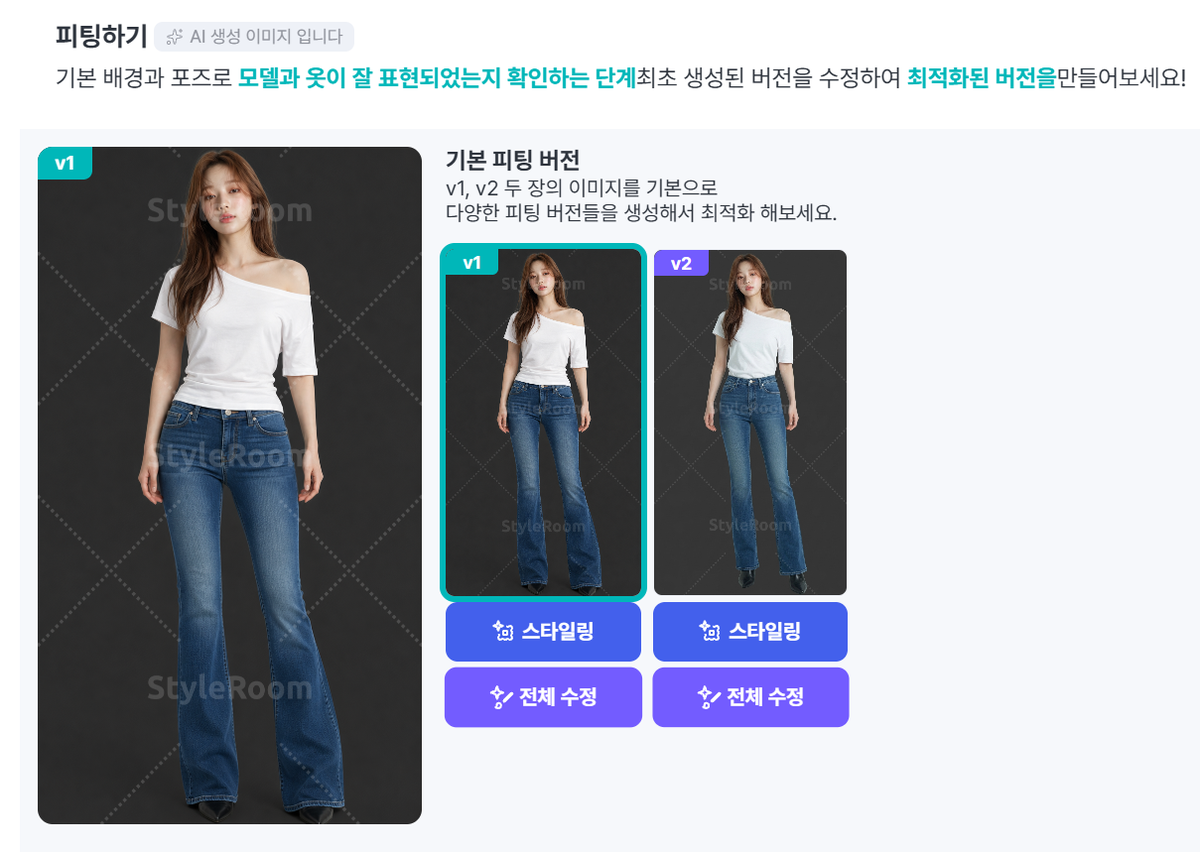
실제 피팅하기 화면입니다. 같은 모델, 같은 옷으로 만들어진 v1과 v2가 나란히 놓이고, 사용자는 둘 중 하나를 골라 스타일링이나 수정으로 넘어갑니다. 그 순간 저장되는 것은 위와 같은 한 줄입니다. 무엇이 좋았는지가 아니라 무엇이 무엇을 이겼는지를 기록합니다. 그것으로 충분합니다.
04 · By Design
"운 좋게 데이터가 쌓였네요"라고 읽힐까 봐 분명히 해 둡니다. 이 데이터는 주운 것이 아니라 제품을 그렇게 생기게 만들어서 나온 것입니다. 세 가지가 갖춰져야 합니다.
- 두 장은 같은 입력 · 같은 조건에서 나와야 합니다. 하나는 오늘 버전으로, 하나는 지난주 버전으로 만들면 그 선택은 판정으로 쓸 수 없습니다. 비교 대상이 통제되지 않은 선택은 소음입니다.
- 고르는 행위가 사용자의 자연스러운 다음 단계여야 합니다. "데이터를 위해 평가해 주세요"라고 부탁하는 순간 응답률과 진지함이 무너집니다. 선택이 사용자 자신에게 필요한 일이어야 판정이 진심이 됩니다.
- 두 장이어야 합니다. 한 장만 만들면 판정 자체가 없습니다. 넉 장을 만들면 고르는 일이 노동이 되고 생성 비용은 배가 됩니다. 두 장은 사용자에게는 "고를 수 있는 최소한의 자유"이고, 우리에게는 "판정이 성립하는 최소한의 구조"입니다.
05 · Handle With Care
정직하게 적어 두면, 선호쌍은 만능이 아닙니다. 선택은 "이 사진이 좋다"가 아니라 "둘 중 이쪽이 낫다"일 뿐입니다. 둘 다 아쉬워도 하나는 선택됩니다. 취향과 품질이 섞여 들어오고, 아무것도 고르지 않은 사용자의 마음은 기록에 남지 않습니다.
그래서 우리는 이 데이터를 정답지가 아니라 나침반으로 씁니다. 쌍 하나하나는 흔들리지만, 수만 건이 모이면 방향이 보입니다. 사용자들은 어떤 실수를 용서하지 않는지, 어떤 차이에는 무던한지. 그 방향이 다음 학습이 힘을 쏟을 곳을 알려줍니다.
06 · Where It Goes
Vol.09에서 우리는 모델에게 "무엇을 그릴지"를 가르치는 이야기를 했습니다. 소분류 LoRA 61개입니다. 선호쌍은 그다음 단계의 재료입니다. "무엇이 나은지"를 가르치는 정렬 학습에 들어갑니다. 그 학습이 끝나면 결과로 다시 찾아오겠습니다.
이 글의 요지를 한 단락으로 줄이면 이렇습니다. 데이터 해자는 모으는 것이 아니라 설계하는 것입니다. 생성은 모델이 합니다. 판정은 사용자가 합니다. 그리고 그 판정이 다음 모델을 만듭니다.