이 시리즈의 Vol.03은 이 한 문장에서 시작했습니다. 범용 이미지 모델은 벌룬 핏을 레귤러 핏으로, 와이드 팬츠를 스트레이트로 바꿔 그립니다. 학습 데이터의 평균으로 회귀하는 것입니다.
처음에는 프롬프트의 문제라고 생각했습니다. 더 길게, 더 구체적으로, 더 강하게 지시해 봤습니다. 결과는 같았습니다. 당연한 일이었습니다. 모델이 모르는 실루엣은, 아무리 정확하게 요구해도 그려지지 않습니다. 언어로 지식을 주입할 수는 없습니다. 지식은 학습으로만 들어갑니다.
그래서 우리는 그 글에서 이렇게 정리했습니다. 단어는 이미 있는 것을 불러올 뿐, 없는 것을 만들지 않는다. 모르는 것은 보여줘야 한다. 그리고 브랜드 한 곳의 실루엣을 LoRA로 가르치는 실험(Vol.05)까지 다녀왔습니다.
이번 글은 그다음 이야기입니다. 실험을 운영 규모로 끌어올리는 것. 브랜드 하나가 아니라 우리가 취급하는 모든 품목을 가르치는 일입니다. 그 과정은 네 번의 갈림길이었습니다.
01 · The Fork
첫 갈림길은 규모였습니다. 밑바닥부터 자체 모델을 만들 것인가, 이미 강력한 오픈 모델 위에 우리 지식만 얹을 것인가. LoRA(Low-Rank Adaptation)는 후자입니다. 베이스 모델의 수백억 파라미터는 그대로 두고, 그 곁에 작은 어댑터를 붙여 특정 지식만 학습시키는 방식입니다. 원본 책은 건드리지 않고 얇은 메모지를 끼워 넣는 것에 가깝습니다. 메모지는 가볍고, 여러 장을 만들 수 있고, 언제든 뗄 수 있습니다.
| 파운데이션 모델 구축 | LoRA | |
|---|---|---|
| 비용 · 기간 | 수백만 달러, 수개월 | GPU 며칠 |
| 데이터 요구량 | 수억 장 | 카테고리당 수백 쌍 |
| 갱신 주기 | 재학습 자체가 하나의 프로젝트 | 분기 단위 갱신 가능 |
| 베이스 발전의 수혜 | 소외된다. 내 모델은 나만 키운다 | 더 좋은 오픈 베이스가 나오면 갈아탈 수 있다 |
| 실패 비용 | 프로젝트 전체 | LoRA 하나 |
표만 보면 당연한 선택 같지만, 결정적이었던 것은 비용이 아니라 주기입니다. 패션의 트렌드는 계절 단위로 바뀝니다. 범용 모델이 새 유행을 반영하려면 다음 버전을 기다려야 하고, 그 사이 반년에서 1년이 지나갑니다. 파운데이션 모델을 직접 만들어도 사정은 같습니다. "무겁게 한 번" 학습하는 물건은 계절의 주기를 따라갈 수 없습니다. LoRA는 "가볍게 자주"를 가능하게 합니다. 유행을 파는 사업에는 후자가 구조적으로 맞는 도구입니다.
물론 한계도 분명합니다. LoRA는 베이스 모델이 모르는 것을 무에서 만들어내지 못합니다. 우리가 이 방식을 택할 수 있었던 것은 목표가 "새로운 능력의 창조"가 아니라 "이미 그릴 줄 아는 옷의 실루엣과 디테일을 교정하는 것"이라는 좁은 과제였기 때문입니다. 도구가 좋아서가 아니라, 과제와 도구가 맞았습니다.
02 · The Base
LoRA를 얹을 베이스는 두 후보로 좁혔습니다. Qwen-Image-Edit 2511(20B)과 FLUX.2 Klein 9B. 둘 다 Apache 2.0 라이선스라 상업적 제약이 같았고, 덕분에 선택 기준은 순수하게 품질 하나로 정리됐습니다.
같은 학습 데이터, 같은 레시피, 같은 평가 세트로 두 모델을 나란히 돌렸습니다. 결과는 일관되게 Qwen의 우세였습니다. 특히 의류에서 치명적인 영역인 프린트, 글자, 짜임 같은 미세 디테일의 재현에서 격차가 났습니다. Qwen-Image 계열이 애초에 텍스트 렌더링에 특화되도록 설계된 모델이라는 점을 생각하면, 사후에 납득되는 결과였습니다.
이 비교전에서 얻은 부산물이 하나 더 있습니다. 데이터와 평가 체계를 특정 모델에 묶지 않고 중립적으로 설계해 두면, 더 좋은 베이스가 나왔을 때 비교전을 다시 여는 비용이 거의 들지 않습니다. 베이스는 바뀐다는 전제로 설계하는 것. 오픈 모델 생태계에서 학습을 운영하는 기본기라고 생각합니다.
03 · Sixty-One
다음 갈림길. "의류 전체"를 가르치는 LoRA 하나를 크게 만들 것인가, 품목별로 잘게 나눌 것인가. 우리는 성별 × 소분류로 나눠 61개를 학습시키는 쪽을 택했습니다.
이유는 단순합니다. 니트가 배워야 할 실루엣과 슬랙스가 배워야 할 실루엣은 다른 지식입니다. 니트에서 중요한 것은 짜임의 질감과 몸을 따라 떨어지는 방식이고, 팬츠에서 중요한 것은 밑위와 통, 밑단이 신발 위에서 꺾이는 방식입니다. 이것을 한 어댑터에 욱여넣으면 서로를 평균 내며 희석합니다. 우리가 고치려던 바로 그 문제를 어댑터 안에서 재현하는 셈입니다.
Vol.03과 Vol.05의 브랜드 LoRA와는 축이 다릅니다. 브랜드 LoRA가 "이 브랜드의 감도"를 배우는 세로축이라면, 소분류 LoRA는 "이 품목의 구조"를 배우는 가로축입니다. 운영에서도 이 구조가 유리합니다. 생성 시점에는 요청된 모델의 성별과 의류의 소분류에 맞는 LoRA 하나만 골라 끼우면 되고, 유행이 바뀌면 바뀐 품목의 LoRA만 다시 학습하면 됩니다. 첫 갈림길에서 말한 "가볍게 자주"가 여기서 완성됩니다.
대분류(아우터 · 상의 · 하의) 아래 소분류마다 남성 · 여성 모델을 각각 학습시켰습니다. 생성 시점에는 이 중 딱 하나가 선택되어 베이스 모델에 얹힙니다.
04 · Pairs
학습 데이터는 스타일룸이 자체 촬영한 사진을 사용했습니다. 여기서 중요한 것은 장수가 아니라 구조입니다. 우리는 낱장의 사진 더미가 아니라 상품컷과 착용컷의 쌍으로 데이터를 설계했습니다. 옷이 걸려 있을 때의 모습과 사람이 입었을 때의 모습을 짝지어 보여줘야, 모델은 "이 옷이 몸 위에서 어떻게 떨어지는가"라는 관계 자체를 배웁니다.
학습 쌍과 캡션. 캡션 맨 앞의 토큰(예시)이 이 지식을 소분류에 묶는 열쇠입니다. 생성 시 같은 토큰을 부르면 해당 소분류의 학습된 실루엣이 소환됩니다.
캡션에는 소분류마다 고유한 트리거 토큰을 심었습니다. 학습된 지식에 이름표를 붙여 두는 것입니다. 이 이름표 덕분에 추론 시점에 "니트 스웨터의 실루엣 지식"만 정확히 불러올 수 있고, 61개의 LoRA가 서로 간섭하지 않습니다.
05 · The Metal
학습과 생성은 모두 NVIDIA H100 80GB 한 장짜리 VM에서 돌렸습니다. "한 장"이 핵심입니다. 20B 모델을 bf16으로 올리면 약 56GB. 여기에 LoRA 어댑터와 작업 버퍼를 더해도 80GB 한 장에 들어갑니다. 우리 규모에서는 큰 GPU 한 장이 작은 GPU 여러 장보다 낫습니다. 모델을 쪼개 얹는 멀티 GPU 분산은 그 자체가 운영해야 할 복잡도이기 때문입니다.
GPU는 Google Cloud에서 썼습니다. 이유는 단순합니다. 학습 데이터와 체크포인트가 이미 GCS에 있습니다. 수십만 장의 데이터를 GPU가 있는 곳으로 옮기는 것보다, 데이터가 있는 곳으로 GPU를 부르는 쪽이 싸고 빠릅니다. VM은 상시 보유하지 않습니다. 일이 생기면 띄우고, 일정 시간 유휴 상태면 자동으로 삭제됩니다. GPU는 소유하는 물건이 아니라 빌리는 시간입니다.
다만 이 방식에는 현실적인 제약이 하나 있습니다. H100은 원하는 존에 늘 재고가 있는 물건이 아닙니다. 어떤 날은 싱가포르에서, 어떤 날은 미국 중부에서, 어떤 날은 유럽에서 잡힙니다. 그래서 VM은 처음부터 "어느 리전에서 부팅되든 스크립트를 받아 같은 상태로 서는" 형태로 만들어 뒀습니다. 재고를 찾아 존을 옮겨 다니는 것이 운영의 일부입니다.
학습 프레임워크는 Qwen-Image를 공식 지원하는 오픈소스 DiffSynth-Studio를 사용했습니다.
생성 쪽의 핵심 기술은 LoRA 핫스왑입니다. LoRA를 쓰는 흔한 방식은 어댑터를 베이스 모델에 병합(fuse)해 버리는 것인데, 우리처럼 어댑터가 61개면 이 방식은 성립하지 않습니다. 병합본 61벌은 20B 모델 61벌과 같습니다. 대신 우리는 베이스 모델 한 벌을 GPU 메모리에 상주시켜 두고, 요청이 올 때마다 해당 소분류의 어댑터만 갈아 끼웁니다. 병합은 되돌릴 수 없지만 핫스왑은 요청 단위로 갈아탈 수 있습니다. GPU 한 장이 61개 소분류를 전부 서비스하는 구조는 이렇게 만들어집니다.
이 구조에서 반드시 확인해야 하는 것이 하나 있습니다. 어댑터를 뗐을 때 베이스 모델이 정말 원래대로 돌아오는가. 우리는 어댑터를 붙였다 뗀 뒤의 베이스 출력이 처음과 비트 단위로 동일한 것을 확인하고서야 이 구조를 채택했습니다. 어댑터 교체가 베이스를 오염시킨다면, 61개가 서로의 결과를 물들이는 재앙이 됩니다.
| GPU | NVIDIA H100 80GB × 1 (학습 · 생성 동일) |
| 클라우드 | Google Cloud. 데이터(GCS)가 있는 곳으로 GPU를 부른다. 유휴 시 자동 삭제 |
| 학습 | DiffSynth-Studio · rank 32 · 12에폭 · 에폭당 체크포인트 |
| 생성 | bf16 상주 베이스(약 56GB) + LoRA 핫스왑 · 40스텝 · 세로 1792px |
| 비교 실험 | 고정 시드. 베이스와 LoRA 적용본의 차이만 남긴다 |
06 · The Recipe
레시피 자체는 담백합니다. rank 32, 12 에폭. 우리가 공들인 것은 값이 아니라 구조입니다. 매 에폭이 끝날 때마다 체크포인트를 저장해서, 학습이 끝난 뒤 열두 개의 시점 중에서 고를 수 있게 했습니다.
이렇게 하는 이유는 LoRA 학습의 실패가 대부분 과학습이기 때문입니다. 너무 오래 가르치면 모델은 옷의 실루엣이 아니라 학습 사진 자체를 외우기 시작합니다. 그런데 "얼마나 가르쳐야 적당한가"는 소분류마다 다르고, 돌려보기 전에는 알 수 없습니다. 그래서 우리는 학습을 되돌릴 수 있는 형태로 설계했습니다. 최적점을 지나쳤다는 것을 나중에 알게 되어도, 그 앞의 체크포인트로 돌아가면 됩니다.
07 · Three Traps
여기까지가 설계라면, 아래는 실제로 부딪힌 것들입니다. 61개를 학습시키는 동안 우리를 가장 괴롭힌 것은 세 가지였습니다.
베이스 모델은 남성 의류 요청에 여성 모델을 그려 놓는 일이 드물지 않았습니다. 생각해 보면 당연합니다. 옷 사진 한 장에는 "이 옷을 누가 입는가"라는 정보가 없고, 모델은 학습 데이터에서 더 자주 본 쪽으로 기울 뿐입니다. 프롬프트로 성별을 지시해도 옷의 생김새가 반대 방향으로 끌면 집니다. 그래서 우리는 소분류를 성별로 한 번 더 쪼개서 남성복 니트와 여성복 니트를 아예 다른 LoRA로 학습시켰습니다. 61개라는 숫자의 절반은 사실 이 결정에서 나왔습니다.
학습 사진에는 옷만 찍혀 있지 않습니다. 구도, 조명, 배경의 무드까지 함께 찍혀 있고, LoRA는 그것을 통째로 배웁니다. Vol.05에서 "설명문에 안 적은 것을 배웁니다"라고 썼던 그 현상입니다. 방치하면 특정 소분류가 상반신 클로즈업만 뱉기 시작하는 식의 부작용이 생깁니다. 학습 사진의 구도가 그랬기 때문입니다.
해법은 캡션의 분리 원칙입니다. 캡션에 적어준 특징은 지시로 제어할 수 있는 변수로 분리되고, 적지 않은 특징은 트리거 토큰에 눌어붙습니다. 그래서 캡션에는 옷의 특징만이 아니라 구도까지 명시합니다. "worn by the person, upper body" 같은 서술을 붙여 두면, 구도는 캡션 쪽으로 분리되어 토큰이 소환하는 지식이 옷에 집중됩니다.
레시피에서 말한 체크포인트 전략은 보험이 아니라 필수였습니다. 학습을 끝까지 돌려 보면, 실제로 투입할 만한 체크포인트는 거의 언제나 마지막 에폭보다 앞에서 나왔습니다. 끝까지 간 모델은 옷의 실루엣이 아니라 학습 사진 자체를 외우기 시작합니다. Vol.05의 결론과 같습니다. 핏이 제일 좋을 때 결과물이 제일 좋은 건 아닙니다. 문제는 그 최적점이 어디인지 돌려보기 전에는 알 수 없다는 것이고, 그래서 "에폭마다 저장"은 학습이 시작되기 전에 설계되어 있어야 합니다. 학습이 끝난 뒤에 세우는 계획은 소용이 없습니다.
08 · Result
소분류 LoRA
중앙값 (255 스케일)
의류 벌 수
61개 소분류 전부 학습을 완주했습니다. 효과는 내부 검증 세트로 쟀습니다. 같은 옷, 같은 시드로 베이스 모델과 LoRA 적용본을 나란히 생성해 비교하는 방식입니다. 의류 27벌 기준으로 두 결과의 픽셀 평균 차이는 255 스케일에서 중앙값 37을 넘었습니다. 미세 조정이 아니라 다른 그림이 나온다는 뜻입니다.
달라지는 방향은 세 갈래로 요약됩니다. 실루엣(통 · 기장 · 네크라인이 상품 쪽으로 이동), 조직과 디테일(짜임 · 플래킷 · 프린트가 되살아남), 그리고 모델 정합(성별 · 체형이 요청대로 고정)입니다. 검증에서 만난 장면 둘만 옮기면 이렇습니다.
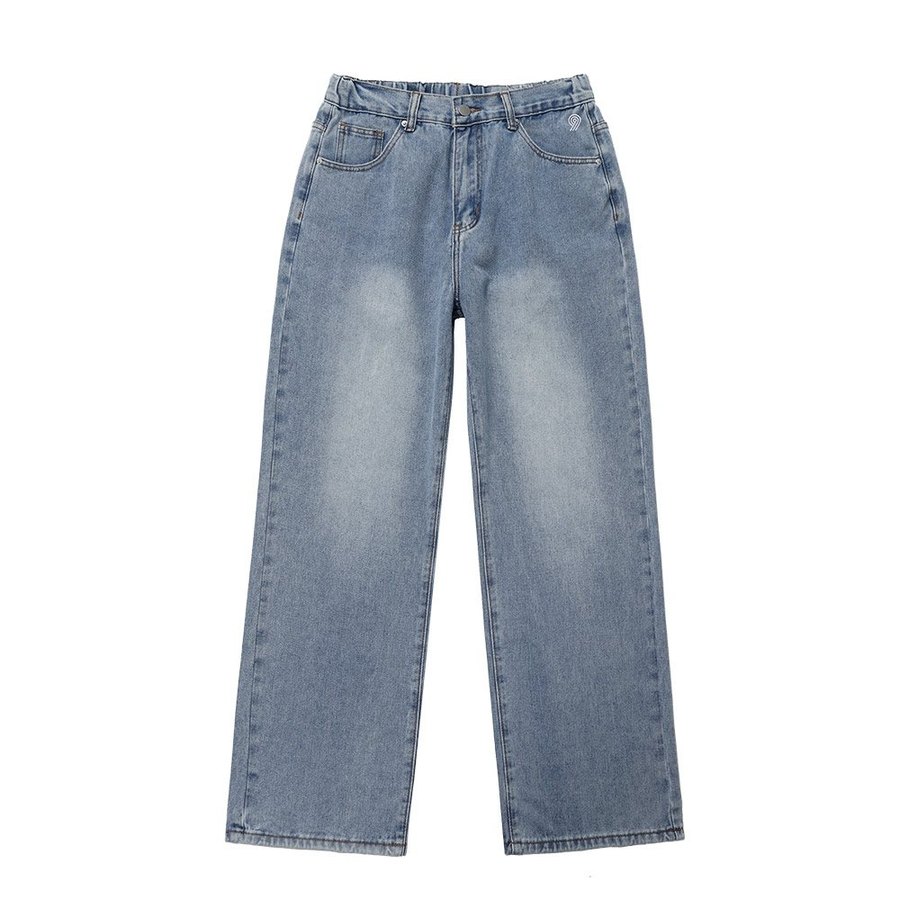
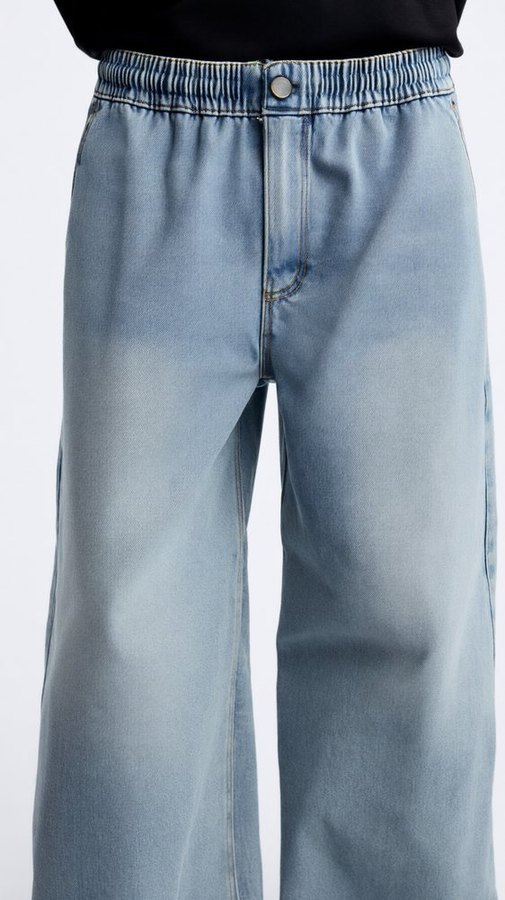
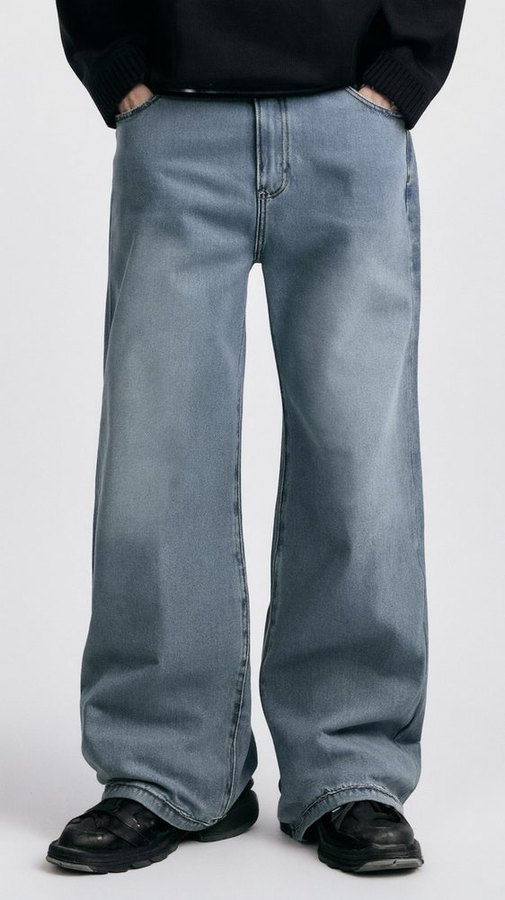
플랫 허리단의 와이드 데님. 베이스 모델은 허리를 고무줄 밴드로 바꿔 그렸고, LoRA 적용본은 허리단과 통을 상품대로 되살렸습니다.
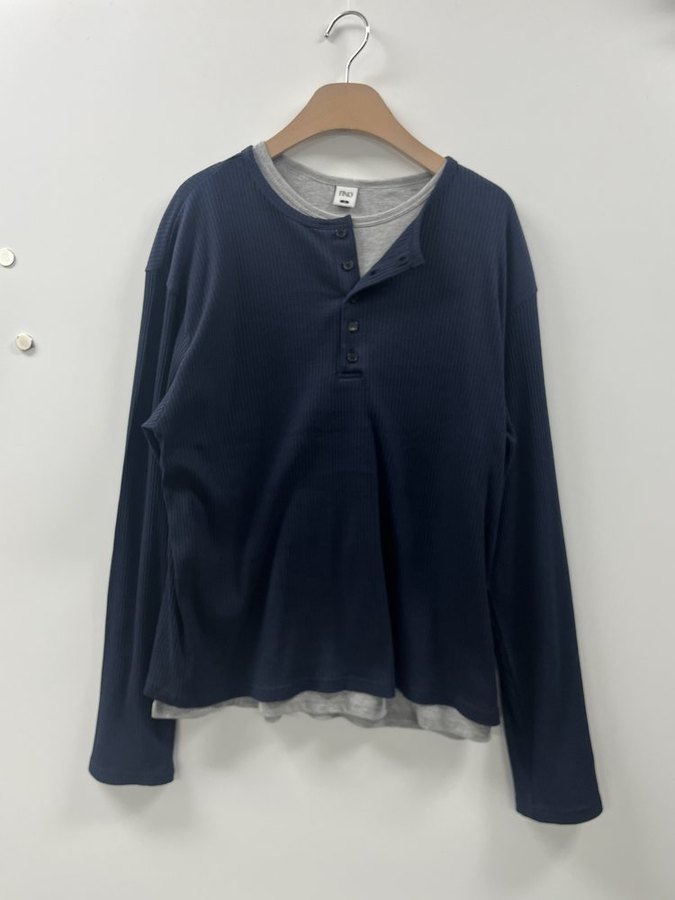
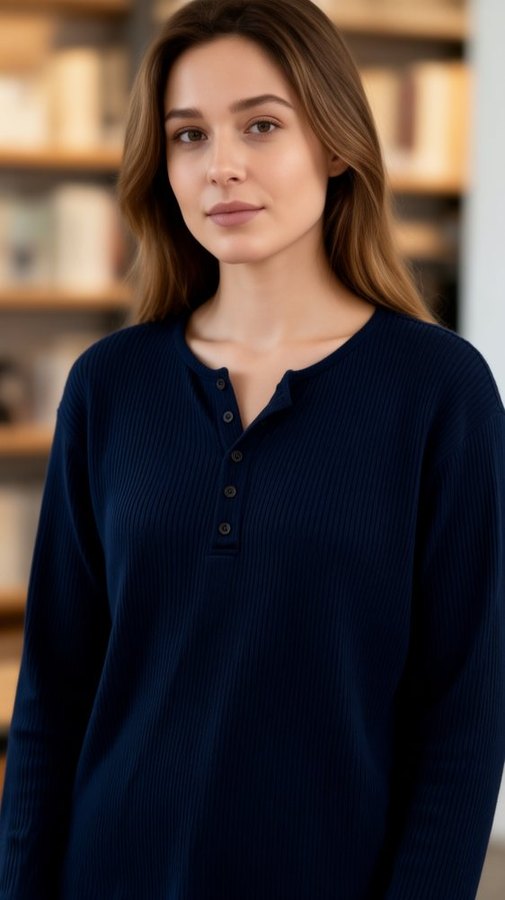
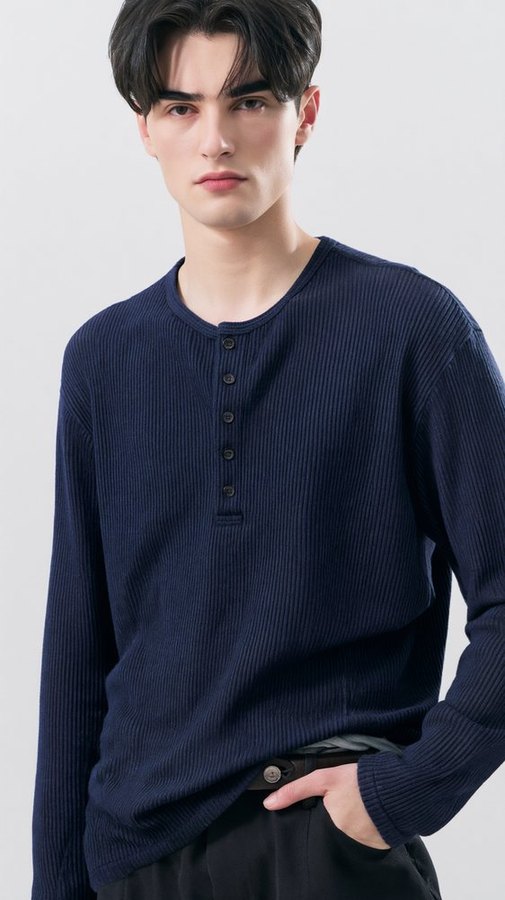
함정 1과 결과가 한 장에 담긴 경우입니다. 베이스 모델은 남성 의류를 여성 모델에 입히고 디테일까지 뭉갰습니다. 소분류 LoRA 하나가 두 문제를 같이 잡습니다.
정직하게 덧붙이면, 모든 품목이 같은 폭으로 좋아진 것은 아닙니다. 짜임과 디테일이 많은 품목(니트, 셔츠류)일수록 개선 폭이 컸고, 형태가 단순한 기본 품목은 베이스 모델도 이미 곧잘 그리고 있었습니다. LoRA는 베이스가 모르는 만큼 일합니다. 그래서 소분류별로 나눠 둔 구조가 다시 유효해집니다. 잘 안 되는 품목에만 힘을 더 쓸 수 있기 때문입니다.
09 · The System
정리하면 네 가지 결정이었습니다.
- 파운데이션이 아니라 LoRA. 트렌드의 주기를 따라갈 수 있는 쪽
- 같은 조건의 비교전으로 베이스 선정. 라이선스가 같으니 품질로만
- 하나가 아니라 소분류 61개. 실루엣은 품목마다 다른 지식이므로
- 낱장이 아니라 쌍. 옷과 착용의 관계 자체를 가르치는 데이터 구조
네 결정은 하나의 방향을 가리킵니다. 우리는 "완성된 모델"을 만들려던 것이 아닙니다. 유행이 바뀔 때마다 바뀐 부분만 다시 가르칠 수 있는 체계를 만들려던 것이고, 그 체계는 지금도 돌아가고 있습니다. 다음 시즌의 실루엣이 등장하면, 61개 중 해당 품목의 LoRA가 조용히 교체될 것입니다.
Vol.03을 이렇게 닫았었습니다. 모델은 빌려 쓰지만, 그 위에 남는 것은 우리 것입니다. 이제 그 문장에 숫자가 붙었습니다. 예순한 개.